假设有一张论文引用网络。我们知道每篇论文的内容特征、论文之间的引用关系,以及少量论文的领域标签,希望预测其余论文属于哪个领域。
GraphPFN 提供了一种处理方式:先在大量合成图任务上预训练;遇到新图后,把已标注节点交给模型作为上下文,用固定参数预测其他节点,也可以继续微调。这句话概括了方法,但还没有解释它怎样成立。
真正需要弄清楚的是:连接关系怎样变成计算?固定的网络为什么能根据新标签改变预测?合成图为什么需要社区、节点度差异和属性生成机制?这些问题分别依赖不同的基础。本篇按理解所需的依赖展开,必要时先离开论文,把一块知识讲完整,再回到 GraphPFN。
| 当前要理解的问题 | 先建立的知识 | 回到论文后能解释什么 |
|---|---|---|
| 连接怎样影响节点预测 | 图表示、度、消息传递、注意力 | 图适配器怎样利用拓扑 |
| 固定参数怎样适应新任务 | 概率分布、贝叶斯预测、跨任务训练 | PFN 与 ICL 的关系 |
| 图任务如何被生成 | 随机图、潜变量、结构方程 | 图结构与属性的联合先验 |
| 哪些设计确有贡献 | 指标、评估协议、受控消融 | 实验结论的支持范围 |
阅读依据是 GraphPFN arXiv v4(2026-08-20),作者为 Dmitry Eremeev、Oleg Platonov、Gleb Bazhenov、Artem Babenko 和 Liudmila Prokhorenkova。所有小图、硬币、人工权重与随机数均为教学例子;论文结果另行注明。本文没有运行 GraphPFN 模型或完成复现。
文中另选取三处论文原图,直接截自同版本 PDF,并在各图旁注明图号、页码和节选范围,便于将教学解释与作者的架构、训练记录和合成样例对照。
1. 从一张数据表开始:图增加了什么
1.1 节点、边与特征分别描述什么
先把五篇论文组织成表格。两个特征暂且理解为它们与 LLM、图学习的相关程度,均为教学数值。
| 论文 | LLM 特征 | 图学习特征 | 已知领域 |
|---|---|---|---|
| A | 0.9 | 0.1 | LLM |
| B | 0.8 | 0.2 | LLM |
| C | 0.5 | 0.5 | 未知 |
| D | 0.2 | 0.9 | GNN |
| E | 0.1 | 0.8 | 未知 |
一行是一个对象,称为节点(node)。表格列描述对象自身,称为节点特征(node feature)。如果再记录“哪些论文引用了哪些论文”,就引入了对象之间的边(edge)。
图写作 , 是节点集合, 是边集合。这里采用无向教学图,边集合为 。真实引用一般有方向;暂时忽略方向,是为了集中理解聚合。
本篇固定节点顺序为 [A,B,C,D,E],数组索引依次为 [0,1,2,3,4]。于是 就是 C 的一行, 检查 C 与 D 是否相连。Context 固定为 A、B、D,Query 为 C、E;Query 的真值即使在生成器中已知,预测时也要隐藏。
表中的 0.9 是人工特征值,不是模型预测的类别概率。D 的两个特征加起来为 1.1 也没有矛盾:特征不要求和为 1。后面还有两种不同对象:隐藏表示 是模型内部向量,类别概率 才需要满足非负且总和为 1。它们可以有不同的维度和含义。
1.2 两个矩阵怎样保留这张图
特征矩阵 有 行、 列。这个例子是 [5,2]:五篇论文,每篇两个数。邻接矩阵 则是 [5,5], 表示有边,0 表示无边。
无向边使 。本例原始对角线为零,即不把“节点与自己相连”预先算进原图。特征与边共同构成模型的输入;未知标签需要单独标记,不能把它直接填成合法类别 0。
矩阵和多维数组统称为张量(tensor)。shape 记录每个轴的长度,轴的含义仍需人为说明。同样是 [5,2],可以表示五个节点的两个特征,也可以表示其他数据。后面读模型时,要同时追踪“有多大”和“每一轴代表什么”。
1.3 邻居、节点度和度分布
节点 C 的邻居集合是 。一条边能到达的节点称为一跳邻居;经过两条边可以到达二跳范围。节点度(degree)是与它相连的边数:
按 A、B、C、D、E 的顺序,本例的度为 [2,2,3,2,1]。因此 1/5 的节点度为 1,3/5 的节点度为 2,1/5 的节点度为 3。这些比例组成经验度分布:
“一个节点有几个邻居”和“整张图的节点度怎样分布”是两个层次。后面随机图模型要控制的是后一个层次,包括是否允许少数高连接节点与大量低连接节点共存。
2. 连接怎样变成计算:从 MLP 到消息传递
2.1 先理解一次特征变换
多层感知机 MLP(multilayer perceptron)由线性层与非线性激活组成。一层可先写成“线性变换后再激活”。 是节点输入向量, 和 是训练调整的参数, 可以是 ReLU,即 。
全文将节点向量写成行向量,一层记为 。若改用列向量,等价写法应为 ,不能把两种方向下的权重原样混用。以 、、 为例:
线性变换组合了原始特征;激活函数把负分量截为零。输入输出都是二维,但数值不同。若中间没有非线性,连续两层线性变换仍可合并为一层,不能由层数本身获得这种分段变换能力。
如果所有节点各自经过相同 MLP,这套计算仍不包含邻接矩阵。固定 ,只改变图边,逐节点输出不会改变。于是需要增加一种让节点读取邻居的操作。
2.2 消息、聚合和更新
最简单的消息传递把邻居特征当作消息,再求平均。对于 C:
随后将自身特征与邻居消息组合。例如把两个向量拼接,得到 ,再由 MLP 更新表示。
这里有三种动作:邻居提供消息,聚合器组合消息,更新函数结合自身信息形成新表示。参数训练决定这些消息最终怎样帮助预测。边只提供可用信息的路径,不保证相邻论文必须属于同一类别。
把更新也算完。取拼接后的 ,设更新矩阵为:
第一通道为 ,第二通道为 。这是得到新表示,尚未得到类别:若另接一个教学分类头,令 logits 为 ,softmax 后第一类概率约为 0.6146。更新参数和分类头都是人为设定,仅展示“邻居消息→节点表示→预测”的接口,不代表训练后的模型。
2.3 GCN 为什么要对节点度归一化
如果直接求和,100 个邻居与 2 个邻居可能带来很不同的数值尺度。平均是一种调整方法,经典图卷积网络 GCN 使用另一种对称归一化:
,上标 是层编号; 是单位矩阵,为每个节点添加自环。 是度矩阵,对角元素 ,其余为零。 将每个对角元素变成 。
于是,只要 允许通信,传播权重就是:
这个系数可从矩阵乘法逐项得到。先右乘对角矩阵:
右侧对角矩阵缩放第 列;再左乘则缩放第 行:
无边位置 ,所以没有贡献;有边或自环的位置才得到前面的非零系数。若只按接收节点的度除,是另一种行归一化;对称形式同时考虑两端节点。它是此处 GCN 的传播定义,并非唯一可能的归一化。
本例添加自环后的度为 [3,3,4,3,2]。C 读取 A、B、D 的系数均为 ,读取自己的系数为 。暂设 并省略激活:
这个结果不是邻居简单平均。对称归一化的行权重也未必加起来等于 1,不能把它当成一组概率。GCN 学习 ,但上述传播系数由结构计算;后面注意力则会按内容计算权重。
2.4 层数、感受野与同质性
一层局部传播读取一跳信息,两层可以把二跳信息送到当前节点。这个能够影响输出的范围称为感受野。叠更多层不保证更好:反复混合可能使节点表示趋同,即过平滑;远处的信息也可能难以完整保留。
在本例中,E 的信息可以先经过 E→D 进入 ,再经过 D→C 进入 。同一层各节点读取上一层的状态,不是先更新 D、再让 C 偷用本层刚更新的 D。
过平滑可以先用一个更简单的两节点平均演示。初始标量表示为 ,两端都取“自身与邻居平均”,一次便得到 ,差异消失。大图与真实 GCN 未必一步趋同,但这个例子明确展示了反复混合为何可能削弱区分。远处很多消息被压进有限向量还涉及信息压缩问题,与这里的趋同不是同一个现象。
标签相近的节点倾向连接,称为标签同质性(homophily);不同标签倾向连接,常称为异配性(heterophily)。例如买家和卖家频繁相连,并不意味着他们属于同一个角色。邻居信息是否有益,取决于任务中的关系规律。
异配性也不等同于异构图:后者指显式存在不同节点或边类型。把这些概念分开,才不会将“能聚合邻居”直接理解为“必然改善分类”。GCN 的原始定义见 Kipf 与 Welling 的论文。
3. 注意力怎样算出“该读谁”
3.1 Q、K、V 是同一份输入的三种投影
聚合邻居时,可能希望相关论文的贡献更大。注意力用输入内容计算相对权重。先把若干输入向量排成 : 是位置数, 是每个位置的隐藏维度。
通过三套参数得到:
查询向量 Query(Q)用于与候选来源比较,键向量 Key(K)参与匹配,值向量 Value(V)是要被加权汇总的内容。它们都是数值向量。这些角色由训练得到的投影实现,不应理解为可直接读出的自然语言问题和答案。
设 的最后一维为 ,则 是 [T,T]:第 行、第 列保存接收者 与来源 的匹配分数。除以 是缩放,缓和维度增加时点积分数的尺度。再逐行做 softmax:
指数把分数变成正数,分母让允许来源的权重之和为 1。输出为 。若 是 [T,d_v],则 [T,T] @ [T,d_v] 得到 [T,d_v]。
先实际产生一次投影。令 ,取 、,于是 ,而 。同一个来源 [1,1] 的键为 [1,1]、值为 [1,2],因为两套投影的用途不同。接下来为了便于手算,另取三组直接给定的值向量;这一步是更换教学参数,不是沿用本段的 。
若查询与键向量的分量近似独立、零均值且方差为 1, 项乘积的和方差约为 ,典型尺度为 ,因此采用这个缩放。这个解释依赖相应统计假设。softmax 也对分数间距敏感:[1,0] 的首项权重约 0.7311,而 [10,0] 约为 0.99995,大间距可能使权重非常集中。
3.2 把一次注意力算到底
取一个接收节点的查询 ,三个来源的键为 、、。缩放后的分数为:
softmax 权重约为 [0.4011,0.1978,0.4011]。如果值分别为 、、,输出约为 [0.8022,0.5989]。
这些权重的中间步骤为 ,分母约 5.0562;每项除以它便得到上面的权重。输出的第一分量为 ,第二分量为 。输出向量本身不要求各分量之和为 1,因为它汇总的是值向量,不是输出类别概率。
接下来假设第 3 个来源与接收节点不相连,给它加入 掩码。其指数权重为零,剩下两项必须重新归一化,变成约 [0.6698,0.3302,0],输出随之变成 [0.6698,0.3302]。
因此掩码不仅把某项输出清零,还改变其他项的相对权重。通用公式为:
允许的位置 ,屏蔽位置为 。数值实现还需要处理某一行完全没有可见来源等情况;本例只计算一个接收位置,该位置屏蔽后仍有两个来源;未列出其他行,不据此推断完整矩阵的边界行为。
3.3 GAT 与 GraphPFN 用的注意力有什么区别
经典图注意力网络 GAT 在邻域内采用加性打分:先令 ,再计算 ,softmax 后加权汇总邻居。LeakyReLU 在负半轴保留一个小斜率。
GraphPFN 的图适配器使用缩放点积注意力,即上一节的公式,加上图邻接掩码。二者都执行基于内容的邻域聚合,具体分数函数不同。多头注意力则使用多套投影,在不同子空间计算关系,再组合结果。其注意力权重也不能直接当成严格的因果解释。
把 GAT 的一条边也展开:若 ,拼接为 [1,0,0,1];令 ,内积为 2,正半轴的 LeakyReLU 保留它。每个候选邻居都这样打分,再在同一个接收节点的邻域内 softmax。这里的 是四维,和拼接向量匹配;点积注意力则分别投影接收者与来源后比较,二者不可直接换名。
多头计算也可以分解。设一个 Token 的隐藏维度为 4,用两头、每头 2 维的投影;第一头输出 [0.8,0.6],第二头输出 [0.2,0.9],先拼接成 [0.8,0.6,0.2,0.9],再乘 得到最终四维更新。各头拥有不同投影,能形成不同匹配;拼接和输出投影负责合并。示例数字不说明各头天然具有可命名的语义。
至此可以区分三件事:MLP 改写每个节点自身的向量;GCN 按结构确定的系数混合节点;图注意力先按内容打分,再在允许的邻居中混合。相关原始定义见 GAT 与 Transformer。
4. 从一个任务走向多个任务:模型需要适应什么
4.1 新节点、新图和新领域不是同一件事
固定模型可以用于新的节点,但新图还可能带来不同的特征数、特征含义、结构模式和标签空间。768 维论文嵌入变成 32 维交易统计,即使通过补齐统一 shape,也没有统一各维的意义。旧任务的类别 0 是论文领域,新任务的类别 0 可能是正常交易,语义也不相同。
图基础模型(graph foundation model)希望通过预训练获得可复用能力,再用于多个任务。它并非一种统一规定的网络结构,预训练 GNN、图 Transformer 与 PFN 路线可以采用不同机制。
| 概念 | 回答的问题 |
|---|---|
| Transductive / Inductive | 预测节点或图在训练中是否已可见,泛化边界在哪里? |
| Fine-tuning / ICL | 新任务通过改参数,还是通过输入上下文来适应? |
| Task-specific / Foundation model | 模型主要为一个任务学习,还是预先学习可复用能力? |
这些维度可以组合。跨图归纳泛化也不自动等于跨领域泛化,新图可能仍来自相近分布。
例如训练时已经观察到 A—E 的特征与所有边,只隐藏 C、E 的标签,是一类图内传导式预测设置;若训练期间根本没有见过另一张图的节点与边,训练后才接收那张图,则是在图层面的归纳使用。还可以只新增一个节点,因此要说明比较的是节点、图还是领域这一层面的“未见过”。
4.2 Context 与 Query 是一次预测中的角色
在一张目标图中,令 是已知标签的节点索引集合, 是需要预测的节点集合。Context 包含已标注示例,Query 是待预测示例。本文用 避免与注意力矩阵 混淆。
模型可以接收 ,对 输出 。这个表达式省略了索引输入,也不表示模型一定显式构造了所有未知标签的联合分布。
ICL(in-context learning,上下文学习)中,参数 固定,但 Context 可以改变,所以中间激活和预测也可以改变。微调(fine-tuning)则在新任务上计算损失、反向传播,更新部分或全部参数。普通预训练模型也可能直接迁移,不能说“不微调就一定无效”。
概率记号要按计算顺序读:模型先输出 ,例如 [0.7,0.3];若生成器保留的真类为 1,则用于监督的 。真值用于选取预测向量的对应项,不作为 Query 的输入。
可以固定 Query 特征,比较两份 Context:前者把相似示例标作类 0,后者交换本任务的类 0/1 编码。一个成功利用上下文的预测器应相应调整输出编码。是否确实如此仍需运行模型验证;逻辑上参数可以不变,因为标签也是输入,改变输入足以改变中间状态。
但还缺一个关键解释:网络为什么学会利用这些示例?这需要先理解一种“给定数据应当怎样预测”的概率目标,再理解 PFN 如何训练它。
5. 先把贝叶斯预测讲清楚:从参数到分布
5.1 一枚硬币对应一个未知参数
令 是硬币下一次正面朝上的概率。给定 ,结果 服从伯努利分布:
若 ,每次正面概率是 0.8;这不要求每五次恰好出现四次正面。这里把抛掷看作给定参数后相互独立,参数在同一任务内保持不变。
看到一个具体序列 后,似然为 。它将数据固定,考察不同参数怎样解释同一观测。最大似然估计选出使它最大的参数 ,属于点估计。
将似然逐项展开:。乘法使用了“给定同一个 后,各次结果独立”的假设。取对数得到 ,导数为 ,令其为零得到 。二阶导数为负,且两端似然为零,所以这里是最大值。似然不是对 归一化后的参数分布,不能单独代替后验。
如果只记录“两正一反”而不记录顺序,似然还会带组合系数 3。该系数与 无关,所以在这里不会改变归一化后的参数后验。
5.2 概率密度为什么可以超过 1
我们还不确定 应取多少,可以用一条分布描述这份不确定性。由于 连续取值,通常用概率密度 。区间概率是面积:
总面积必须为 1,曲线高度可以超过 1。密度值不是“参数恰好等于某一点”的概率;在连续密度模型中,单点概率为零,区间才有非零面积。
把 [a,b] 切成许多宽为 的小段,每段概率近似 ,相加为 ;分段越来越细,得到积分。密度 2 持续在宽度 0.1 的区间,贡献的概率约为 0.2,不是 2。积分的权重还包含区间宽度,所以“密度高度大于 1”和“总概率不大于 1”并不冲突。
5.3 Beta 分布怎样表达先验
概率参数取值在 [0,1],Beta 分布正好定义在这个范围。其密度为:
分子规定曲线形状,分母把总面积调整为 1,称为归一化。取 时,分子恒为 1,,得到均匀密度。
均匀先验表示在这种参数化下不偏好某一段等长区间,不表示我们已经知道硬币公平。Beta(10,10) 则把更多质量放在 0.5 附近;Beta(0.5,0.5) 更偏向两端。先验(prior)描述的是看到当前任务数据之前的假设。
形状也能从分子看出:当 ,分子是 ,中间的乘积较大,靠近端点则趋近零;当二者为 0.5,分子是 ,靠近端点升高。分母统一面积,不改变同一条曲线不同位置的相对高低。
5.4 先验乘似然,得到后验
贝叶斯公式将观测证据与先验结合:
是让后验总面积为 1 的常数。以 Beta(1,1) 和序列 [1,1,0] 为例,未归一化后验为 ,积分为 。因此:
归一化常数可直接算:。所以除以 等于乘 12。
一般更新也来自指数相加:
右侧恰好是 Beta 的未归一化密度形式,再归一化即可。因此“更新计数”是这个指数运算的结果。
更一般地,先验 Beta 观察 次正面、 次反面,后验为 Beta。分布形式保持一致,只更新参数,这种先验与似然的搭配称为共轭。
5.5 后验与后验预测回答不同问题
先用有限参数模型理解加权:假设只可能有两种硬币,正面概率分别为 0.2 和 0.8,看到数据后它们的后验权重为 0.25 和 0.75,那么下次正面概率为 。这里有两个不同的“概率”:硬币本身的正面概率,以及我们对硬币是哪一种的后验权重。连续情形将这两项相乘求和推广成积分。
后验回答“根据观测,哪些 更可信”;我们实际想问的是“下一次正面的概率是多少”。需要让每个可能参数给出预测,再按后验密度加权:
这就是后验预测(posterior predictive)。积分累积的是不同参数下的预测贡献,得到 0.6;最大似然点估计则为约 0.667。
一般 Beta–伯努利模型的预测为 。可将 直观理解为预测中的先验伪计数,但它们不是实际观测次数,这里的计数形式对应预测均值,不在此混入其他点估计对象。
5.6 从硬币推广到监督学习
先让硬币带上一个输入。取函数族 ,。任务参数可能为 或 ;若 ,两种机制的正类概率分别约 0.7311 与 0.2689;若 ,两者反过来。一次采样 后,用它生成多个 ,便得到一份有输入的分类任务。
此处把 当作给定的设计输入,或假设其采样不额外提供关于 的信息。若输入本身也与任务参数耦合,一般模型就需要把这部分观测纳入后验条件;不能把下面的简化记号不加条件地推广到任意联合生成模型。
如果任务参数 决定一个函数 ,输入 对应输出 ,预测要计算:
硬币只是一个容易求解的例子。复杂函数、潜变量和非线性依赖下,这个积分可能很难直接算。先验描述可能的任务机制,似然描述机制怎样产生数据,后验用数据更新对机制的判断,后验预测再据此预测新结果。
硬币预测对 恰好是线性的,积分等于后验均值;一般非线性模型中, 不等于 。因此不能普遍用“平均参数”替代后验预测。下面的 PFN 正是围绕这个预测目标展开。
6. PFN 怎样通过训练学会推断
6.1 两种参数必须分开
PFN 全称 Prior-Data Fitted Network:定义一个先验,生成数据,再用这些数据训练网络。这里同时存在两种参数:
| 符号 | 归属 | 怎样产生与变化 |
|---|---|---|
| 某个任务的潜在机制 | 生成任务时采样,同一硬币任务中固定 | |
| 共享预测网络 | 跨任务预训练时通过梯度更新 |
例如生成器先采样 ,用这枚硬币生成 Context [1,1,0,1,1] 和下一次 Query 结果 1。网络只看到 Context,输出下一次为 1 的概率 0.65。这个输出是教学设定,生成器没有把真实 告诉网络。
这一次损失为 。反向传播更新 ,不会去修改已经用于生成任务的 。下一轮再采样另一枚硬币、另一批观测,让同一网络继续学习。
在均匀硬币先验下,仅根据上述四正一反的 Context,理想后验预测是 ,并非生成器内部的 0.8。网络要学的正是可见观测条件下的预测,而不是猜中每个任务采样出的隐藏参数。
从 到 也不是换个名字。先采样一份任务机制,再在机制内生成样本:
前两个采样步骤是生成器执行的动作;最后一个积分描述它们共同诱导的数据集分布,训练时不必先计算这个分布的密度。硬币的一次任务共享同一 ,不同任务重新采样,因而“多个任务”和“同一任务的多个观测”不能互换。
6.2 摊销推断与 ICL 分别描述什么
如果每来一个任务都重新运行昂贵的推断算法,重复工作很多。摊销推断(amortized inference)提前训练一个共享映射,将前期成本分摊给后续任务。
PFN 希望让 近似先验对应的后验预测。ICL 描述它的使用方式:把新任务的观测作为输入,在前向传播中适应。摊销描述计算成本如何转移,PFN 描述训练框架,ICL 描述任务适应方式,Transformer 则是一种实现这种映射的网络架构。
预训练结束后,给硬币网络不同 Context,输出自然可以不同。参数固定并不表示输出固定。它也没有在推理时必然显式计算一个贝叶斯积分,网络是通过训练近似这个结果。
6.3 从一个 Query 的损失,逐层建立训练目标
先固定网络参数 、一份任务 ,以及 Context / Query 划分 。Context 数据记为 。模型对 Query 先输出类别概率向量,再取真类别对应的分量。
一个 Query。 定义负对数损失:
若三类预测为 [0.7,0.2,0.1],真类为第 2 类,则 。条件右侧没有 ,真值只用于选分量、计算误差。
一次固定划分。 对这次 Query 中的样本平均:
若两个 Query 的真类概率分别是 0.8 和 0.5,损失为 0.2231 和 0.6931,这次任务调用的平均损失约为 0.4581。这里 ;平均使不同 Query 数量的任务不会仅因样本更多就自然占更大权重。
一份任务的不同划分。 规定划分采样规则 ,定义:
假设只允许两种等概率划分,损失分别为 0.4581 和 0.6931,那么 。若划分概率不是各一半,必须按实际概率加权,不能简单平均所有可写出的划分。
不同任务。 再定义跨任务风险:
是最小目标值, 是达到该值的参数集合;使用 不预设最优参数唯一。训练寻找一组跨任务共享参数,不是每个任务各自找一套权重。
把上面的定义依次代回,得到:
长式子的每一层现在都有一个先前定义的对象:单样本损失、固定划分平均、划分期望、任务期望,最后是参数优化。这是一般分类 PFN 的概念目标;GraphPFN 的条件还包括整图特征与结构,且训练有额外的 MGM 项。
实际批次。 采样 份任务,每份采样一次划分,得到有限估计:
例如两个任务损失分别为 0.4 和 0.8,批次损失是 0.6。简化梯度下降执行 , 为学习率。期望是学习目标,采样批次是估计,梯度更新是一次优化动作;有限更新不保证达到全局最优。论文实际优化器采用 AdamW,不能把这条简化式当作其完整更新规则。
6.4 为什么生成的单个答案也能监督概率
一次 Query 只有 0 或 1,为什么能训练出 0.6 这样的预测?设固定 Context 下,下个结果为 1 的真实条件概率是 ,模型预测为 。重复遇到这种条件时,期望二分类损失为:
这个期望可先写成两种可能结果的加权和:,对应损失 ;,对应损失 。将它们按发生概率相加,才得到 ,并非单次观测直接提供了软标签 。
对 求导:
当 、,二阶导数 ,所以驻点是唯一最小点。若 或 1,最优预测在边界,应按极限理解对数损失。这些条件不能从“导数为零”省略掉。
因此长期平均损失要求输出正确的条件概率。生成任务时可以直接用 Query 的真实结果监督,不必先求出精确贝叶斯后验作为标签。
推广到多个类别,交叉熵是 ;熵 表示真实分布自身的不确定性;KL 散度 衡量用 近似 的偏离。它非负,且一般不对称。三者满足:
等式可以逐项组装:,所以
例如 ,,,KL 为二者之差约 0.2231。真实分布固定时,它自身的不确定性不随 改变;改变预测只能减少额外偏离。这里要求真概率非零的位置预测不为零,否则损失可能无限大。
固定 ,第一项不变,理想情况下最小化交叉熵就逼近 。这里的 是先验生成过程诱导的条件分布,因而连接到了贝叶斯后验预测。正式论述见 PFN 原论文。
这需要模型有足够表达能力并且优化有效。GraphPFN 还冻结了部分网络,并加入辅助目标,不能把理想结论直接写成其已经实现精确贝叶斯推断。对于以 MSE 训练的回归输出,平方损失的最优解是条件均值,不等于输出完整预测密度。
回归的区别也能直接看出。固定条件信息 ,令 ,预测一个数 :
展开平方后,交叉项因 消失。第一项不依赖 ,所以最优 。例如条件下目标等概率取 0 与 2,预测 1 的 MSE 为 1,预测 0 的 MSE 为 2。一个点预测只需要输出均值,未必描述双峰等完整分布形状。
7. 回到 GraphPFN:从一个标签走到一个预测
先看作者的整体架构,再逐步落实到下面的 Token 和数据路径。
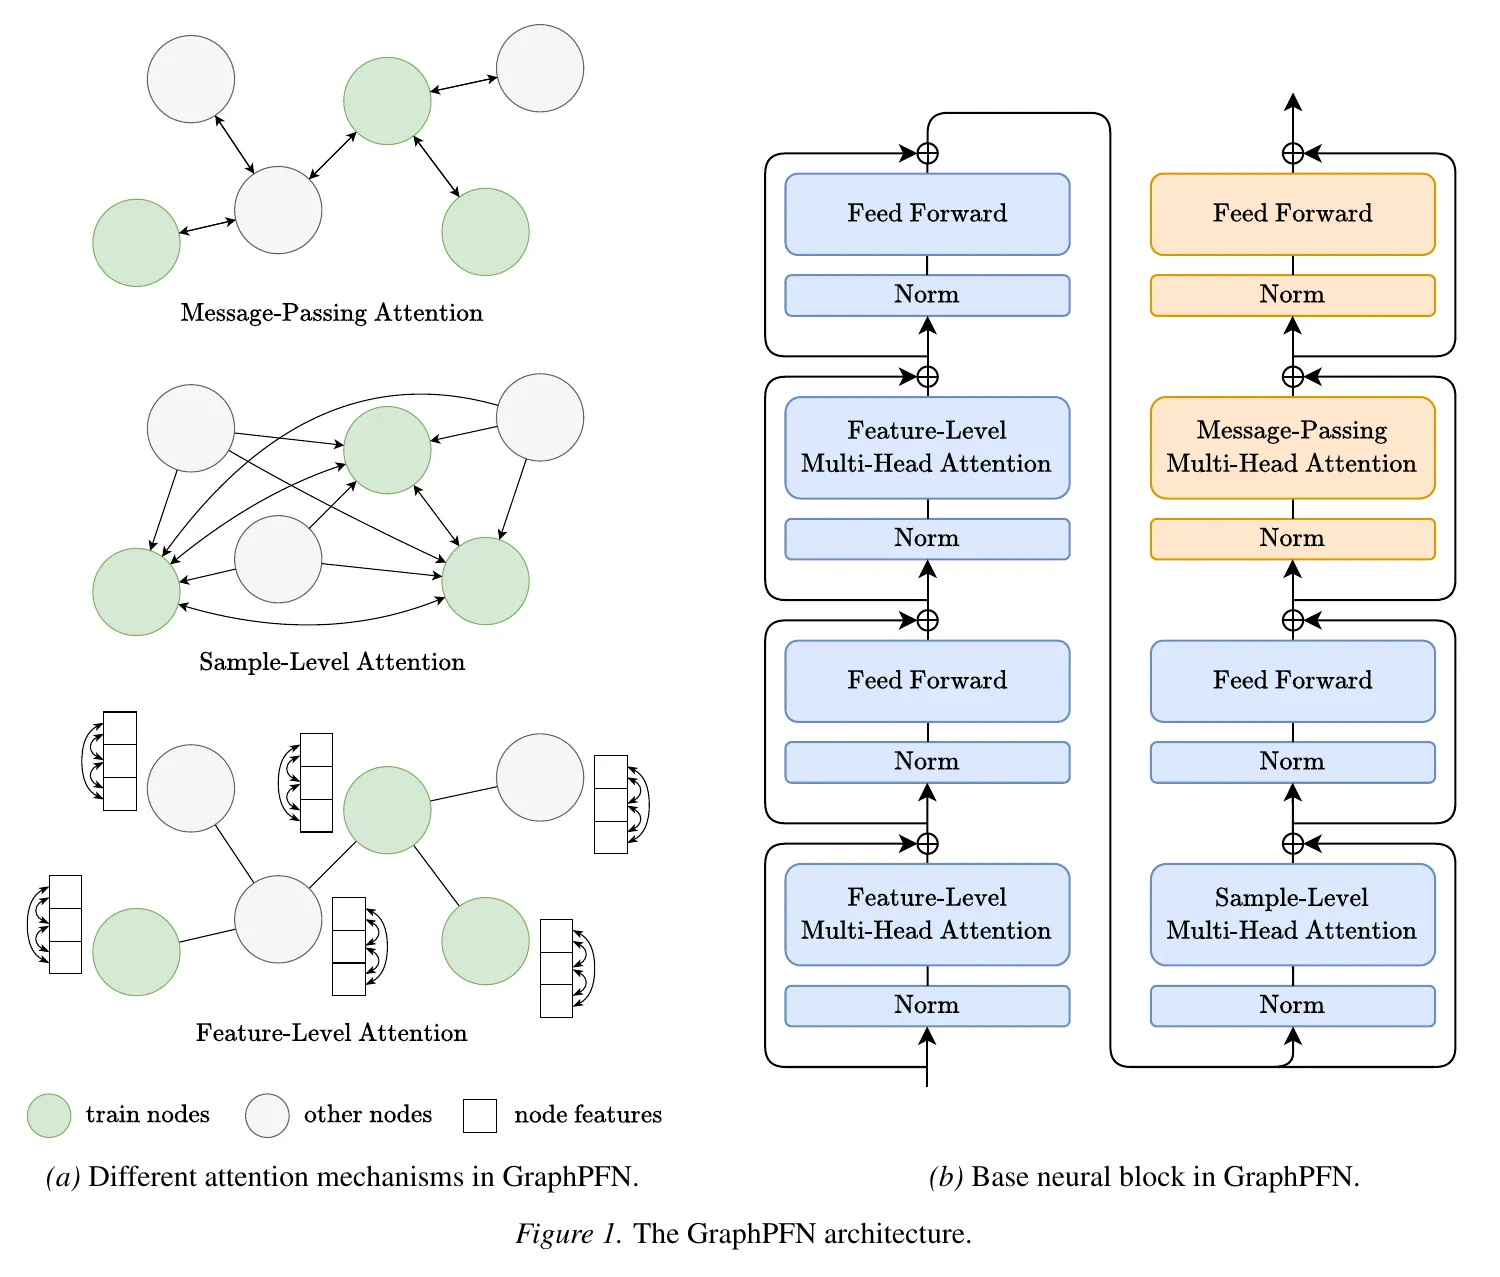
原图出处:Eremeev 等,GraphPFN,arXiv v4,Figure 1,PDF 第 4 页;图形及英文图注直接截取,未重绘。查看原页。
左侧绿色是已标注训练节点,灰色是其他节点,三种箭头分别表达不同的通信范围。右侧要沿箭头阅读:从左列底部向上,顶部连线转到右列底部,再向上进入橙色的图消息传递和 FFN。这样能辨认蓝色的表格骨干与新增图适配器各占哪一段;后面的手算图再负责展开其中的一次操作。
7.1 固定源码版本,先把节点与标签放到正确位置
本章依据论文 v4 及官方仓库固定提交 3b9b115490249cc777227c846babfb55f35bd8c4 的论文实验代码。下面将已确认的数据路径与手算参数分开:路径来自源码,低维权重和概率用来教学,不是预训练权重的真实输出。
图的原始节点顺序为 [A,B,C,D,E],Context 为 A、B、D。代码先稳定重排成 [A,B,D,C,E],让已知标签连续位于前 3 个位置,eval_pos=3。特征行重排,边端点也必须同步映射:旧边 CD 的索引 (2,3) 变成新索引 (3,2)。模型输出再按逆置换恢复原节点顺序,不能只移动特征而保留旧边索引。
7.2 特征组与目标 Token 分别编码
一行两个原始特征在 LimiX 中作为一组,先经过预处理与特征编码器,变成一个隐藏向量。为示意嵌入,令一组值 乘教学矩阵 ,得到四维 [x₁,x₂,x₁,x₂]。真实编码器还处理缺失、分组和特征位置,不是只用这个矩阵。
标签不直接塞进每个特征数值。分类标签经过本任务类别编码后,查表得到类别嵌入 ;Query 的标签位置被设为 NaN,并使用专门的未知目标嵌入 。源码的 EmbYEncoderStep 对 Context 调用 y_embedding,对 Query 调用 y_mask,所以未知类别与合法类别 0 有不同表示。
特征组 Token 之后,再沿 Token 轴拼接一个目标 Token。设原始特征数为 ,特征组数为 ,总 Token 数为 。记号 [N,F,d_h] 中的 包含这最后一列,不能只数特征组。例如 [5,2] 原始特征变成一组特征 Token 加一个目标 Token,概念尺寸为 [5,2,d_h];代码还带批次轴 [1,5,2,d_h]。
对于 C,特征 Token 描述 [0.5,0.5],目标 Token 起点是 ;对于 A,特征 Token 描述 [0.9,0.1],目标 Token 起点来自其类别嵌入。这一步把已知答案与特征同时放进了后续计算可读取的位置。
7.3 追踪一格隐藏状态怎样更新
Feature Attention 固定节点,取出该节点所有 Token。C 的目标 Token 可以读取自己的特征 Token,因而未知目标状态开始依赖 C 的输入。Sample Attention 则固定 Token 位置,在节点轴读取 Context:C 的目标 Token 读取 A、B、D 的目标 Token,后者既包含类别起点,也可能已经通过特征交互包含节点属性。
用一个低维教学更新说明这一接口:设 A、B、D 目标位置的值向量分别为 [1,0]、[1,0]、[0,1],C 的注意力权重为 [0.4,0.4,0.2],则 C 在此子层得到的消息为 [0.8,0.2]。若仅将 A 的标签改成另一类,并在此局部演示中固定权重,消息变成 。真实网络里标签还可能改变键、查询与权重,不能认为权重一定保持不变。
这里“Query 节点”是任务角色;注意力矩阵 是所有接收者的查询投影,Context 也会产生自己的查询向量。行表示接收者、列表示来源,不随图的画法变化。
7.4 两种跨节点通路与跨子层影响
| 子层 | 固定的对象 | 可读取的范围 |
|---|---|---|
| Feature-Level | 一个节点 | 该节点的特征组与目标 Token |
| Sample-Level | 一个 Token 位置 | 所有 Context 节点,不要求有图边 |
| Graph Adapter | 一个 Token 位置 | 一跳邻居,允许已标注与未标注双向传递 |
沿具体状态看组合效果:第 个 Block 的图适配器可以把 Query C 的状态送到相邻 Context B,得到新的 ;后续 Block 的样本注意力允许 Query E 读取 Context B,于是 C 的信息可以间接影响 E。后一步读取的是已经更新的 B,不是永远固定的原始 Context。这里传播的不是 C 的真实标签,因为它从未作为输入提供。
因此,Sample-Level 内“不读 Query 来源”和整个模型内“Query 彼此独立”是不同判断。一跳图适配器也不意味着整个 Block 只有一跳影响范围,因为另有全局 Context 通路。
7.5 把一个子层和一个 Block 的操作拆开
以适配器的源码形式为例,先做 LayerNorm,再计算子层更新,最后加残差:。一个二维向量 的均值为 2、总体方差为 1;忽略稳定常数 ,取缩放 、偏置 ,归一化得到 [-1,1]。实际 LN 计算 ,作用在该 Token 的隐藏通道,不跨节点求统计量。
若子层对这个归一化输入输出 [0.2,-0.1],残差结果为 [1.2,2.9]。FFN 则逐 Token 变换通道:例如 [-1,1] 经过恒等矩阵、ReLU 得 [0,1],再乘 得 [1,-1]。这是示意参数;官方图适配器 FFN 使用 Linear→GELU→Linear,隐藏宽度扩大后再缩回。FFN 本身不读取其他节点,跨节点信息来自此前注意力。
LimiX 有两种特征注意力子层及样本注意力,GraphPFN 在骨干 Block 后加图注意力残差和 FFN 残差。不能仅根据模块名称推断执行顺序:固定源码的 fmfmsm 分支依次为 Feature→FFN→Feature→FFN→Sample→FFN,随后是图适配器;配置从 LimiX 检查点读取,代码还支持其他分支。本次未加载该权重文件,不将构造函数默认分支写成已实测的检查点配置。论文图中的模块示意与程序分支应分别对照。
为了看清状态,每个实际子层都可依次记成 ,每次读取上一子层输出。特征交互会修改单个节点的一整行,样本与图交互会修改某一 Token 位置的一列;输出放回同一网格,形状可以一直不变。
7.6 Query 的目标 Token 怎样变成类别概率
源码完成编码后取 encoder_out[:, eval_pos:, -1]:只取 Query 节点、最后一个目标 Token,而非平均全部特征。分类头为 Linear→GELU→Linear,得到类别 logits;论文包装器输出 log-softmax,训练可以直接对相应真类计算损失。MGM 也使用最后一列目标嵌入形成节点对表示。
继续前面的教学状态,假设只取前两类、分类头在本例输出 logits [0.8,0.2],softmax 为 [0.6457,0.3543],于是预测类 0。如果状态变成 [0.4,0.6] 并采用相同的教学恒等读出,概率约为 [0.4502,0.5498],预测类 1。这里用恒等读出替代真实头,只是为了算通接口;真实模型有自己的多层参数与最大类别数。
到这里,路径已明确为“类别编码→目标 Token→特征与样本交互→图更新→Query 目标 Token→分类头”。源码依据:图包装与边头、特征和目标 Token 的拼接及读取、类别与未知目标嵌入、子层执行分支。
8. 暂时离开论文:怎样生成有规律的随机图
8.1 随机图模型给出的是分布
任务先验需要生成 。按生成顺序可写作 。本章先解决 ,下一章再解决节点属性。
随机图模型为不同邻接矩阵分配概率。同样参数重复采样,可以得到不同的图;但平均度、社区倾向等统计特征可能相近。某个节点的期望度,可以理解为相同参数下反复生成图时,它的度的长期平均,所以可以不是整数。所谓“随机”不等于“没有规律”,规律体现在采样概率和依赖结构里。
最简单的参照是 Erdős–Rényi 模型:每对不同节点独立以相同概率 连边。在 节点无向图中,每个节点期望度为 。它没有额外规定哪两组节点更容易连接。要表达不同群组的关系,可以让概率依赖组别。
逐边概率还能组成整图概率。ER 在固定节点集上有 个无序节点对,若图有 条边,独立采样给出这张指定图的概率 。例如三节点、,指定图只有 AB 和 BC 两条边,概率为 ;没有 AC 也是一次需要计入的采样结果。
这是参数固定时的 。如果每个任务先随机选择 ,总体分布还要平均这些参数:。换一张随机边样本和换一套连边机制,是不同层次的随机性。
8.2 SBM 为什么叫随机块模型
SBM 是 stochastic block model。Block 指共享一套连接概率规则的节点组;按组排列邻接矩阵时,矩阵会分成若干区域,所以称为“块”。Block 不必都是内部稠密的社区,也可以描述二部结构中的两侧。
给每个节点一个块编号 ,再定义 的概率矩阵 。以六个节点为例,A、B、C 在第 1 块,D、E、F 在第 2 块:
同块配对的连边概率为 0.8,跨块配对为 0.2。给定 后,各无序节点对独立采样,再令 ,对角线保持零。
具体采样时,可为每对节点生成 :若 ,就连边。例如 AB 的随机数为 0.10,则连边;AC 的随机数为 0.90,则不连。跨块 AD 如果抽到 0.10,也会连边。
为让右侧样本可核算,列出所有无序节点对的教学随机数;下三角由对称性省略:
| 节点 | A | B | C | D | E | F |
|---|---|---|---|---|---|---|
| A | — | 0.10 | 0.90 | 0.10 | 0.60 | 0.70 |
| B | — | — | 0.20 | 0.80 | 0.10 | 0.40 |
| C | — | — | — | 0.50 | 0.90 | 0.10 |
| D | — | — | — | — | 0.30 | 0.70 |
| E | — | — | — | — | — | 0.85 |
| F | — | — | — | — | — | — |
逐项执行 ,生成边为 AB、BC、DE、DF、AD、BE、CF。单个样本并不需要恰好满足“80% 内部边”,尤其节点很少时,波动很明显。
本例固定了 与 ,只随机采样边。预训练还会改变块数、块大小、连接强度及节点倾向;这些超参数的分布再诱导多样任务。固定参数时,SBM 的整图概率也可写为 ,前提仍是给定块参数后逐对独立。
8.3 社区结构怎样从概率中出现
每个三节点块有 对潜在内部边,期望内部边数为 ;两个块之间有 对潜在边,期望跨块边数为 。
比较社区时要看密度或连接倾向,不能只看边的绝对数量,因为候选配对数不同。这里内部候选边更容易出现,因而倾向形成稠密群组。若把 的四项全设成 0.5,块编号便不再影响边概率;若非对角线更大,则倾向跨组连接。
块编号 在生成器内部已知,交给模型的数据却可以不包含它。这叫潜变量(latent variable):它参与生成,但不直接观测。结构块编号与预测标签 也没有必然相等关系,GraphPFN 会另行生成目标。
8.4 普通 SBM 对节点度有什么限制
块大小固定为 时,第 块内节点的期望度为:
先写一个具体节点:若 A 在第 1 块,,取期望后为 。同块只有 个其他节点,异块 有 个,因此逐组整理便得到上面的通式。线性期望本身不要求边独立;独立性是这里完整 SBM 分布的额外假设。
在六节点例子中,每个节点期望度都是 。同块节点拥有同一种度分布,无法单独表达“这个节点长期更活跃”。实际采样的节点度仍可以不同,但差别来自随机波动。
如果现实网络同一社区中有少数枢纽和许多低度节点,仅靠同块共享概率就可能不够灵活。普通 SBM 可以增加块来表达部分差异,但这可能把“活跃程度不同”与“群组关系不同”混在一起。度修正希望把这两个因素分开。
8.5 Degree Correction 修正的是生成强度
给节点增加连接倾向 ,让一对节点的连边机制同时依赖块关系和两端活跃程度。这里使用 ,避免与预测网络权重 混淆。
一种经典形式采用泊松边计数:
泊松变量取 0、1、2 等非负整数,均值是 ,。因此 是期望边数或强度,不是必须小于 1 的伯努利概率。如果把多重边投影成简单边,即有至少一条边便令 ,则:
这一步先改变了随机变量类型: 是有无边的 0/1, 是边的条数, 是条数的期望。泊松零边概率是 ,所以 。投影后才重新得到简单图的有无边概率。
以下是独立于前一节 0.8 / 0.2 设置的教学例子:同块基础强度为 0.2,A、B、C 的倾向为 0.5、1、1.5,得到 AB、AC、BC 的强度分别为 0.10、0.15、0.30,对应简单边概率约 0.0952、0.1393、0.2592。B、C 更容易连接,是生成前的机制差异,不是采样后再把节点度改大。
参数还存在尺度问题:把一块内所有 乘常数,同时调整 ,可能得到同一组强度。因此需要约束,例如规定每块 之和为 1,或者采用等价的均值约束。上面的教学图采用块内均值 1,并对所有方案使用相同的基础强度;它不承诺平均边数也完全相同。
例如原来 A、B 的倾向为 0.5、1,同块强度为 0.2,。把同块所有倾向乘 2,并把同块强度除 4,便有 。若只放大一个块,跨块强度也需相应除 2;这说明不加约束时,数值参数可以不同而生成强度相同。
固定版本的官方 sbm.py 采用“先采样块间边数,再按块内归一化的节点倾向抽端点”,最后化为简单图的实现。它不是逐对执行本节的独立泊松教学采样器;本节公式负责解释度修正原理,不能替换为官方采样的精确概率公式。查看固定实现。
这段推导解释度修正的思想,采用的是经典泊松形式及其简单图投影,不能当作 GraphPFN 官方采样器的逐行实现。度修正也有其他变体,不能把任意 不加限制地当概率。原理依据见 Karrer 与 Newman。
8.6 Multi-level SBM 组合了什么
度修正解决同块活跃程度,未必充分描述交错的结构。GraphPFN 先生成若干第一层度修正 SBM 图,再生成一张节点总数相同的第二层图,用随机双射 对齐两层节点,最后取边的并:
一对节点可能在第一种分组下同组,在第二种分组下异组;另一对则相反。两层贡献的连接可以交错,不必由一套整齐的分区完全解释。这里 multi-level 指这种两层生成与组合,不等于节点在社区树中逐层细分。
作为独立采样的简单教学例子,若同一节点对在两层的连边概率是 0.8 和 0.2,至少一层连边的概率为 。实际两层分组、参数和对齐会共同影响最终结构,不能用这一数字概括论文先验。
把双射具体化。另设六节点第一层边 ,第二层节点为 1—6、边为 。给出映射:
| 第一层节点 | A | B | C | D | E | F |
|---|---|---|---|---|---|---|
| 第二层对应节点 | 1 | 4 | 2 | 5 | 3 | 6 |
将第二层边映回:12→AC,23→CE,45→BD,56→DF。最终边集为 。原先 ABC 与 DEF 两片结构,因 CE、BD 产生跨区连接;AC、DF 则补充原区内边。映射必须作用到两个端点,不能只改节点标签的文字。
这份独立例子专门解释多层合并,不替换全文五节点图。固定源码通过打乱第一层节点编号,再与第二层同编号图合并实现同样的对齐思想;还会处理最大连通分量,实际节点数可能因此减少。
8.7 PA 从“图怎样增长”出发
优先连接 PA(preferential attachment)采用时间过程:从初始图开始,逐步加入新节点。已有节点度越大,越容易吸引新边。最简单的一次目标选择规则为:
取本篇五节点图作为种子,度为 [2,2,3,2,1]、总度为 10。新节点 F 如果只加一条边,选择 A、B、C、D、E 的概率依次是 [0.2,0.2,0.3,0.2,0.1]。
把这一次目标选择也执行出来:累计区间依次为 A [0,0.2)、B [0.2,0.4)、C [0.4,0.7)、D [0.7,0.9)、E [0.9,1)。若教学随机数是 0.55,落在 C 的区间,便新增 FC。这是按权重抽样,不是直接挑度最大的节点。
若本次抽中 C,则 C 的度变成 4,F 的度为 1。下一个新节点 G 面对的已有节点度是 [2,2,4,2,1,1],总度为 12;C 的吸引概率变成 ,F 的是 。概率会随历史更新。
这与 SBM 的差别在生成机制:SBM 按块和参数规定节点对关系,PA 按图的增长历史选择连接。基本 PA 没有显式提供社区概率矩阵。在线性优先连接等特定条件下会出现重尾度分布,但不能把任意有限 PA 图都直接宣称为严格幂律图。相关经典工作见 Barabási 与 Albert。
GraphPFN 以多层 SBM 图为起点,再加入低度节点,并随机选择新节点的初始度。这样用块模型组织较密集核心、交错连接,用增长过程补充外围低度节点。它们分别控制不同结构倾向;普通 SBM 本身也能通过特定块参数表达核心—边缘,不能说只有组合才可能生成这种结构。
结构效果也可以局部观察:本篇种子度分布是 [2,2,3,2,1],加上刚才一条 FC 后为 [2,2,4,2,1,1]。C 成为更高连接的节点,外围多了一个度为 1 的 F;这不意味着一次操作就证明了整个网络是幂律。多层合并演示了交错边来源,PA 演示了外围与度更新,二者各有实际控制点。
组合方案改变了结构出现的频率和可控方式,其预测价值仍需消融验证。后文会看到,复杂先验并非在每个任务上优于简单度修正 SBM。论文的具体生成方案见 Section 4.1。
讲完生成步骤,再对照作者实际展示的合成图样例:
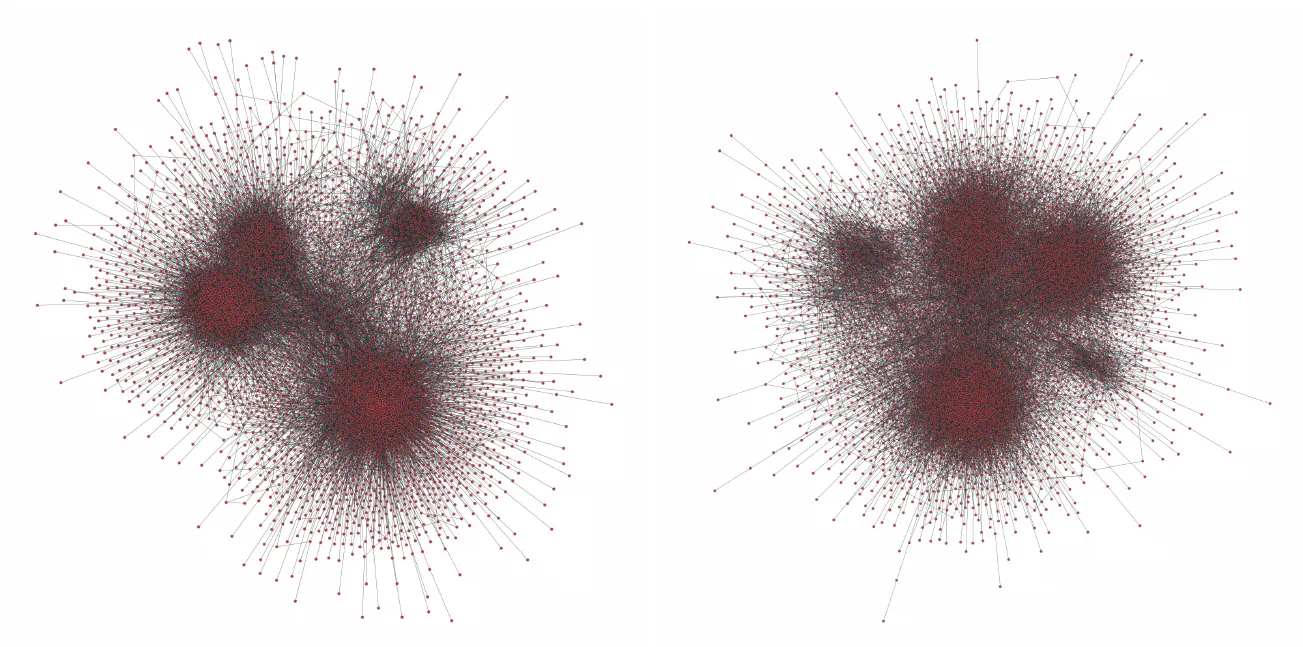
原图出处:Eremeev 等,GraphPFN,arXiv v4,Figure 3,PDF 第 17 页,上排两幅节选。完整图共六幅,此处只裁取前两幅,未改动其中节点与边。查看完整原图。
可以先看密集区域,再看它们之间的连接与外围节点,将前面“社区结构”和“核心—边缘”的解释对应到可见形态。这些是作者先验生成的样例,节点在纸面上的位置属于可视化布局;下游预测效果仍要由第 11 章的实验和先验消融判断。
9. 有了边以后:SCM 怎样生成特征与目标
9.1 单独随机填入 X 和 Y 为什么不够
假设图结构很复杂,但每个节点的特征和目标都独立抛硬币生成。模型无法从特征和边得到比标签先验更多的预测信号。要产生可学习任务,需要指定变量之间的依赖,即 。
“特征是随机的”不等于“特征与目标独立”。同一组随机输入通过共同机制产生 ,便可以保留可预测关系。结构因果模型 SCM(structural causal model)是表达生成依赖的一种方式。
9.2 结构方程和潜变量到底是什么
先看一个完全明确的教学系统:
外生变量 提供系统外部的变化,结构方程规定其他变量怎样由它们计算。这里 同时影响 。若只观测后两者, 就是潜变量;在分析 与 的关系时,它还构成共同原因。不是所有隐藏变量都自动是混杂因素。
在无噪声教学取值下, 分别生成 。观测上 很能预测 ,但方程并没有规定 产生 。若在模型内干预 ,即替换掉它的生成方程而保持 不变, 的方程不会随之改变。
先规定本例的外生量:令 等概率取 [-1,0,1],。固定某次 ,自然生成 。如果干预强行令 ,只替换 方程,得到 ;如果改的是 ,则两个下游变量都会变化。这个差别来自明确写出的方程,不来自观测相关性的大小。
因此“可预测”与“已知真实因果关系”不同。GraphPFN 使用人工 SCM 生成任务,不代表它能从目标图中识别真实因果结构,也不代表神经网络的每条计算边都具有现实因果含义。
9.3 随机神经网络怎样组织大量结构方程
可以用前馈网络的计算单元表达不同非线性方程:随机选择层数、隐藏宽度、激活函数和权重,再输入随机变量。一次采样确定一套生成机制,同一个任务的多个节点共享这套机制;下一任务重新采样。
从中选部分神经元作为观测特征,另选一个作为目标,其他变量保持潜在。预测目标不必来自网络最后一层,也不要求所有特征都在目标上游。
这里有三个角色:外生输入产生样本变化;随机生成器参数规定本次任务的规律;GraphPFN 参数则学习如何预测这些任务。生成器在此通过前向计算供给数据,不是在用目标图标签训练另一个教师模型。
随机网络便于组合高维非线性依赖,但通用近似能力不保证随机初始化能覆盖真实机制;人工规则也能生成丰富任务。选择神经 SCM 是一种先验设计,需要通过迁移结果检验。
构造一份可见的神经计算表。取五节点输入 ,第一层对每个行向量 [uᵢ] 使用权重 [1,2,-1],产生三列 ;若下一步用 ReLU,最后一列变成零。这份任务内所有节点共享该层权重;节点差异来自输入,下一任务才重新采样权重或结构。
“选择神经元”在数据表中就是选择一列在所有节点上的输出。例如第 2 列是一整个长度为 5 的向量 [2,4,6,8,10],不是仅选 C 节点上的数字 6。官方 extract_features_and_labels 会将中间层状态沿通道拼接,再选观测列和目标列;选择最后层目标或中间目标由配置决定。源码。
9.4 给结构方程增加邻居输入
普通逐节点 MLP 方程只处理自身变量,图可能尚未影响 。GraphPFN 每层同时计算 MLP 与 GNN 候选,再逐神经元选择来源。概念表达为:
每个任务采样 ,以及 Mean、Max、Min、GCN、GT 中的一种聚合方式。前三项分别取邻居均值、最大值、最小值,GT 指 Graph Transformer 式聚合。 控制神经元选择 GNN 的概率,不是把两个输出按 连续加权,也不直接代表标签同质性。
用一维教学变量 说明:设某个候选 MLP 神经元输出 ,候选 GNN 神经元输出 。对于 C,,。选 MLP 就取 6,选 GNN 就取约 2.333; 不表示这一次必然输出两者均值。
这个例子只展示一层两种候选,不是官方 SCM 实现。真实生成器还会组合多层变换、随机权重和不同聚合,再抽取特征及目标。
把候选选择放回所有节点。若层里有两条输出通道,掩码为 ,第一列取各节点的线性结果,第二列取聚合结果;同一份 广播给五行,不为每个节点重新抽一次。下一层有自己的掩码,下一任务重建网络时重新抽样。固定源码 MixedGraphLinear 在构造时生成长度为 d_output 的缓冲区;前向顺序是先算 linear(x),再对它做图聚合,最后按通道选结果。源码。
为了将“选列”走到完整任务,下面采用一个独立的确定性教学生成器。它简化了随机网络的深度与噪声:保留 ,生成 ,另以原始 的邻居均值作为目标候选 。观测列选 ,隐藏 ,并取 :
| 节点 | 原因列 u | 自身候选 a | 隐藏目标 b | 输出特征 X 的一行 | 输出标签 y | 预测角色 |
|---|---|---|---|---|---|---|
| A | 1 | 2 | 2.5 | [1,2] | 0 | Context |
| B | 2 | 4 | 2 | [2,4] | 0 | Context |
| C | 3 | 6 | 7/3 | [3,6] | 0 | Query,真值隐藏 |
| D | 4 | 8 | 4 | [4,8] | 1 | Context |
| E | 5 | 10 | 4 | [5,10] | 1 | Query,真值隐藏 |
所以最终 是 [5,2],;模型只获得 。这份 替换了最初的论文相关度特征,边和节点顺序保持不变;两列相关度与这两列生成特征不能在一次计算里混用。
阈值 3 是教学设定。官方任务后处理先标准化连续目标;二分类按采样分位数确定边界,支持反转与类别置换;多分类按观测值或随机数确定多个边界,再分配类别。因此“随机 SCM 产生连续目标”和“转换成分类任务”是两个步骤。官方后处理。
9.5 两种图与两条结构依赖路径
观测图 的节点是论文、用户等实体,可以有环;SCM 的依赖图描述变量如何计算。在按层展开的前馈生成中,后一层只使用前面已有变量,因而数据图中的双向边并不自动造成结构方程的同层循环。
用层编号展开一条往返路径:,三个位置是三个不同变量。它没有让 同时依赖尚未算出的 ,所以观测图上的 AB 双向关系不构成同一计算时刻的方程循环。
论文还将 Degree 和 PageRank 各以 0.5 的概率加入生成器输入。PageRank 可以理解为随机游走加重启所对应的节点访问权重:除了直接边数,也考虑连接到该节点的其他节点在全图中的位置。
在五节点无向图上取均匀初始访问权重,每个节点为 0.2。先只做一次沿边的随机游走,C 收到 A 的 、B 的 和 D 的 ,合计 0.3。若以概率 0.15 均匀重启,C 的下一步权重为 。完整 PageRank 继续迭代至相应稳定状态;这一步只是展示“访问权重”怎样产生。
若把 Degree 加入前面的教学生成输入,A 的输入行会从 [1] 变成 [1,2];某个结构方程若取两项之和,A 输出便从 1 变为 3。结构特征因此有明确的进入位置,而非一个只在图注中出现的名字。
因此图信息有两种入口:结构统计量进入输入,以及 GNN 神经元进行消息传递。只有 且没有注入结构统计量时,才退回不依赖拓扑的表格 SCM。推理时也不因此要求人为给 GraphPFN 添加 PageRank,它属于此处的先验生成机制。
现在可以解释为什么图先验是完整方法的一部分:它规定模型会接触哪些拓扑,也规定哪些属性—目标依赖值得学习。目标分布超出这些假设时,增加合成任务数量也不能自动消除先验失配。对应原文为 Section 4.2。
10. 把生成器与预测器接起来:完整预训练
10.1 一次训练迭代中什么可见
生成器得到 后,采样 Context 索引 与 Query 索引 。模型读取结构、所有节点特征与 ; 暂时保留,只在预测之后计算监督损失。
节点分类输出类别分布,用交叉熵训练;回归输出连续值,用 MSE(均方误差,即预测残差平方的平均)训练。Logit 是归一化前的实数分数,sigmoid 函数 将一个分数变成 0–1 范围的概率。二分类可以输出单个 sigmoid 概率,也可以用两个 logits 再 softmax;多分类通常输出 个概率。这里说明一般任务表示,不声称是官方预测头的逐行实现。
沿用上章生成表,取 Context A、B、D,模型可见三行标签 0、0、1;C、E 真值 0、1 留在监督侧。假设一次教学前向给出 C 的类概率 [0.8,0.2]、E 的 [0.3,0.7],则真类概率分别为 0.8、0.7:
这里假设概率只为了演示损失,不声称已经用官方权重从这份输入计算出了它们。分类真值必须按 Query 顺序 [C,E] 对齐,不能拿 Context 标签或重排前的错误位置监督。
10.2 MGM 为什么先移除真实边
论文增加 masked graph modeling(MGM,掩码图建模)提供结构监督:随机抽取 10% 的真实边作为正样本,从输入图中移除;再从原始非边中采样等量负样本。模型用缺边图计算表示,然后判断被挑选的节点对是否原本相连。
必须先移除正边,否则适配器可能直接沿需要判断的边通信,使任务过于直接。这里不要求移除所有间接路径,模型正是利用剩余关系推断缺边。
取最后一层两端节点的目标嵌入,做逐元素乘积 ,由附加 MLP 进行二分类。例如 、,乘积为 [3,8],不是点积得到的 11。交换两端不会改变乘积,符合无向节点对的对称表示。
具体选择原始正边 CD 和原始非边 AE。移除 CD 后,输入边集变成 {AB,AC,BC,DE};CD 的边监督为 1,AE 为 0。这个小图为便于展示只隐藏一条边,占原始五条的 20%,不冒充论文的 10% 配置。
上述 在原图上已经生成好,遮边后不重算标签。若相反用缺边图重算目标,预测任务本身也变了。对剩余图做一次前向,节点监督与边监督使用同一次输出;缺边还可能改变节点预测,前文的 0.8、0.7 在此是这次缺边前向的假定值。
边头也走到损失。假设目标嵌入 ,于是 、。用教学线性头 ,得到边 logits 0.6 和 -0.5,sigmoid 概率约 0.6457、0.3775。真实边头是 MLP,这里线性头便于手算。
同一份 C、E 嵌入也可以产生前面的节点概率,而不必另造一份隐藏状态。取教学二分类头的第 0 类分数为 、第 1 类分数为 0,其中 、。则 ,softmax 为 [0.8,0.2];,softmax 为 [0.3,0.7]。这样节点与边两分支使用同一组目标表示。嵌入本身仍是教学假设,未冒充从官方权重算出的中间值。
正边惩罚“存在边的概率太低”,负边惩罚“存在边的概率太高”。官方训练采用 binary_cross_entropy_with_logits,将 sigmoid 与对数损失合在数值稳定的运算中。训练实现。
总目标是:
系数 0.1 缩放的是 MGM 项及其对共享参数的梯度贡献。损失尺度和梯度方向仍决定实际影响,它不表示模型有固定 10% 的能力来自 MGM。
把同一次前向的两项合并:。反向传播沿这两个计算分支回到共享目标表示和图适配器,边头也获得自己的梯度。
10.3 哪些参数在什么时候更新
| 阶段 | 输入与监督 | 参数状态 |
|---|---|---|
| 合成图预训练 | 合成 Context、Query 真值与边监督 | 论文主体策略为冻结 LimiX、训练图适配器;MGM 边头也需训练 |
| 目标图 ICL | 当前图与 Context 标签 | 全部固定,只做前向计算 |
| 主实验目标图 FT | 当前任务的训练监督 | 微调整个模型;附录另有仅适配器微调 |
冻结参数不等于切断经过这些层的梯度。冻结骨干仍执行变换,训练时梯度可以穿过它,回到前面可训练的适配器。这里保持固定的是骨干权重本身。
| 预训练设置 | 论文报告值 |
|---|---|
| 合成任务总数 | 1,600,000 |
| 优化步骤 | 10,000 |
| 每个优化步骤 | 8 张 GPU × 20 次梯度累积 = 160 份任务 |
| 硬件与耗时 | 8 × NVIDIA A100 80GB,约 36 小时 |
| 优化器 | AdamW,基础学习率 ,weight decay 0.1 |
| 学习率调度 | 前 10% 步数线性 warmup,随后余弦退火 |
| EMA 衰减 | 0.98 |
梯度累积表示多个小批次先累计梯度,再做一次优化器更新,所以 。Warmup 让初期学习率逐渐升高;EMA 是对适配器权重进行指数移动平均,可概括为 ,平滑逐步更新的波动。
冻结可用一个标量链解释:可训练参数 产生 ,固定层权重 产生 ,损失 。取 ,得到 。梯度沿链为 、、。学习率 0.01 的简化梯度更新使 ; 仍为 3。若切断固定层的输入梯度,前面的 就无法获得这项更新,和仅冻结 不同。
梯度累积也应与任务计数分开。若两次损失对一个参数的梯度为 2、6,分别将损失除以累积次数 2 再反向,累积梯度就是 ,然后优化器只更新一次并清零。多 GPU 再聚合各卡梯度;论文的 loss / n_gradient_accumulation_steps 与这个平均思想对应。
AdamW 使用一阶、二阶移动统计调整梯度步长,并将权重衰减作为独立的参数收缩项;表中 0.1 是该超参数,不是训练损失的 10%。本节不展开优化器全套递推,将其保留为复现设置。EMA 也可算一步:旧平均参数为 1、新权重为 1.5 时,,表示平滑后的模型参数,不是又更新一次梯度。
源码还需区分“骨干主要冻结”与“所有非适配器参数都冻结”:GraphPFN 会构造可训练边头,feat_head=True 时还会解冻特征解码器;训练脚本可按配置增加特征损失。论文叙述的两项目标不等于代码所有可选配置。本次不加载检查点、不执行整套预训练,不据构造函数默认值宣称论文最终运行启用了哪一项可选特征目标。
这些是论文的继续预训练设置,不包括原始 LimiX 的训练成本。MGM 提供辅助结构监督,也不意味着当前模型已经成为通用链接预测器。具体训练配置见 Section 3.2。
10.4 对照原论文的预训练曲线
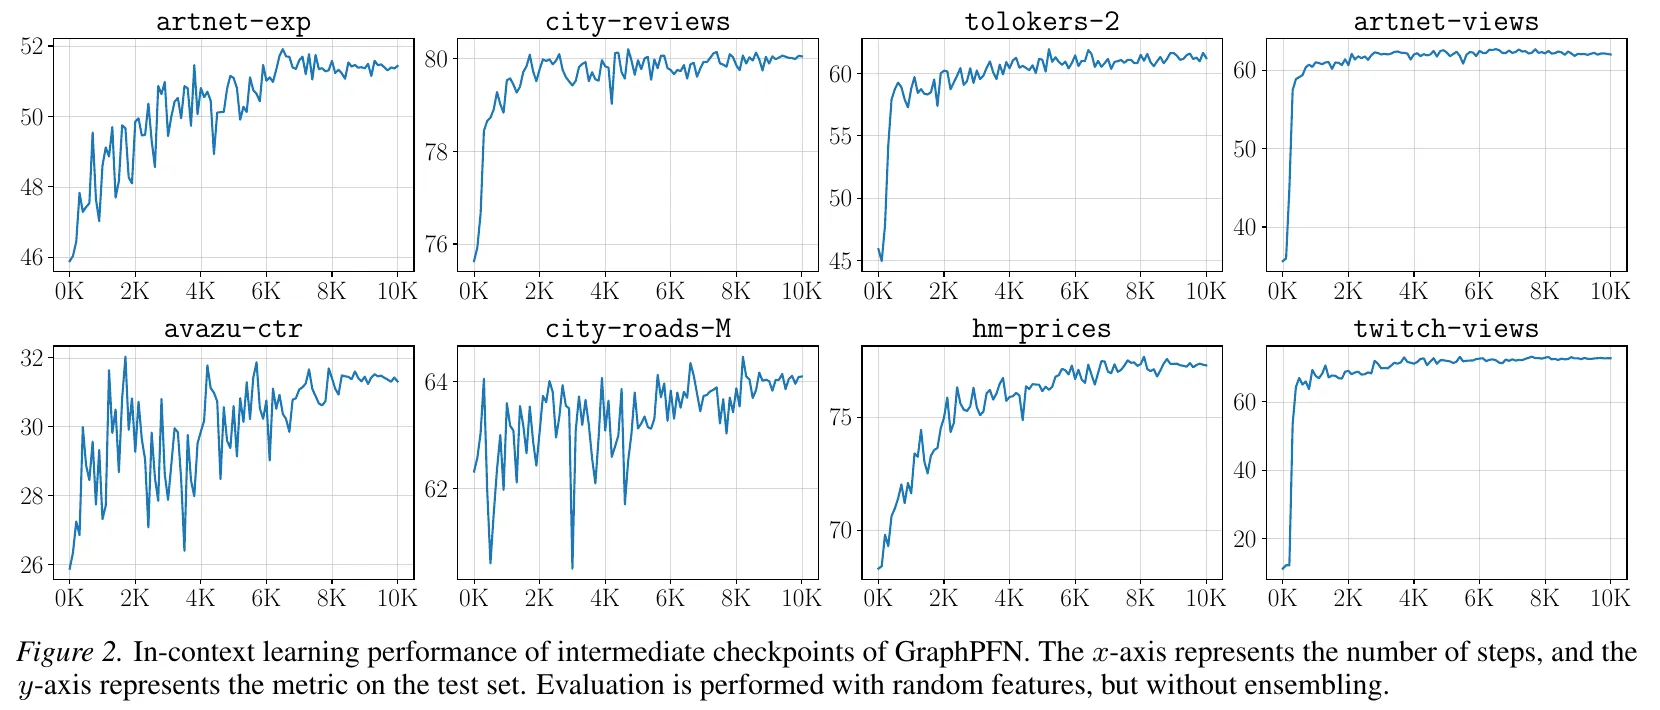
原图出处:Eremeev 等,GraphPFN,arXiv v4,Figure 2,PDF 第 5 页;保留全部八个子图和英文图注。查看原页。
这张图记录的是预训练过程中,各检查点迁移到真实图后的 ICL 表现。横轴 2K 表示约 2,000 个优化步骤,纵轴是各任务的测试指标,不是合成任务的训练损失。分类子图采用 AP,回归子图采用 R²,沿用原图的百分数刻度与各自纵轴范围,因此应观察同一子图随步数的变化,不能直接比较不同子图曲线的高度。
例如 artnet-views 与 twitch-views 在早期上升很快,而 artnet-exp 的改善更渐进;这让前面抽象的“持续预训练”对应到论文中的实际记录。图注注明随机特征开启、集成关闭,不能把曲线末点直接当作默认集成主表的结果。论文还说明,每 100 步进行一次此类评估,测试成绩仅用于事后分析,没有用于提前停止或选择模型。
11. 实验精读:哪些结果支持了哪些判断
11.1 先对齐任务、指标与运行方式
主实验包含 8 个 GraphLand 数据集和 5 个经典数据集,采用 10% / 10% / 80% 的训练、验证、测试划分。ICL 将训练标签作为 Context;GNN 用训练标签优化参数;GraphPFN FT 继续微调。传统 GNN 基线也使用了残差、归一化、MLP 模块与超参数搜索。
| 任务 | 数据集 | 指标 |
|---|---|---|
| 二分类 | artnet-exp、city-reviews、tolokers-2、questions | AP |
| 多分类 | amazon-ratings、facebook、pubmed、wiki-cs | Accuracy |
| 回归 | artnet-views、avazu-ctr、city-roads-M、hm-prices、twitch-views |
任务类型按论文 Table 10 确认。artnet-views 和 avazu-ctr 属于回归,不能把它们的结果读作 AP。 表格型的 CTR 目标在此基准中也不应仅凭名字推断成二分类。
主表默认将多次预测集成:GraphPFN 与 G2T-LimiX 平均 10 次前向结果,GraphPFN 每次还增加 8 维随机特征。因此“ICL 不更新参数”不等于主表只调用一次模型。
划分比例以外,还要区分标签用途。ICL 以训练标签作 Context,验证与测试标签不作为该次预测输入;验证分数用于比较目标任务设置或微调进度,测试成绩在选定设置后报告。在 FT 的一个梯度步中,不能一边把某节点真值放进 Context,一边把同一个节点当作未知答案来计算有效的 Query 监督;需要在训练标签中再形成当前步的 Context / Query。
论文 Appendix D 说明,微调每步只采一个集成成员,而每十步的中间评估使用完整集成。代码中的节点重排、类别变换与预测逆变换都必须同步。当前笔记不把公开包的默认步数、早停耐心等直接写成论文每个数据集的实验配置;复现应读取对应论文实验配置与划分文件。
集成可以追踪到单个节点。若三次在同一类别顺序下的预测为 [0.8,0.2]、[0.6,0.4]、[0.7,0.3],概率平均为 [0.7,0.3];不是先取三个 argmax 再投票。若成员置换了类别,必须先映回原类别再平均。随机特征则将 [N,P] 扩成 [N,P+8],例如 [5,2]→[5,10],各成员重新采样;不能把它当作八个新节点。
11.2 先理解指标,再比较数字
Accuracy 是正确分类比例。AP(average precision,平均精确率)针对正类排序:按分数从高到低读样本,每遇到一个正样本,就看截至此处的 precision,再按召回增量加权。
Precision 是当前选中节点中真为正类的比例 ;Recall 是全部正类中已经被选中的比例 。将阈值逐渐降低,更多节点进入选中集,形成 precision–recall 的一系列点。AP 按召回的增量为 precision 加权,不是简单平均每个排序位置。
例如四个节点的真实标签按预测分数排序为 [1,0,1,0]。两个正样本分别出现在第 1、3 位,其 precision 为 1 与 2/3,所以 AP=(1+2/3)/2=5/6。它评价排序,不要求先选分类阈值,也不等同于准确率或梯形积分的 PR-AUC。
回归的决定系数定义为:
例如真实目标 [1,2,3]、预测 [1,2,2],误差平方和为 1,目标偏离均值的平方和为 2,因此 R²=0.5。在目标方差非零的通常定义下,0 表示与用评估目标均值作常量预测相当,也可以为负。
AP、Accuracy 与 R² 不能直接混合平均成“平均准确率”。论文使用平均排名 AR,越低越好;排名只记录相对顺序,不记录第一名领先多少,且依赖参与比较的模型集合。
平均排名也可以亲手计算。两个任务里,甲、乙、丙分别排名 [1,3,2] 与 [2,1,3],则甲的 AR 为 1.5、乙为 2、丙为 2.5。同一任务的指标差距 0.01 或 10 都只表现为一个名次差;加入或删除参评方法还会改变排名,因此只能在同一排名协议内比较。
11.3 选几个结果,看收益和反例
下表摘录 Table 1 的均值,省略原表的标准差;只在同一行比较。为便于阅读,AP 保留百分数尺度, 从原表的百分数尺度换回通常的实数形式。
| 数据集与指标 | GAT | G2T-LimiX ICL | GraphPFN ICL | GraphPFN FT |
|---|---|---|---|---|
| artnet-exp · AP(%) | 45.06 | 48.42 | 51.79 | 53.49 |
| city-reviews · AP(%) | 77.74 | 78.98 | 80.25 | 80.90 |
| tolokers-2 · AP(%) | 57.41 | 61.60 | 61.29 | 62.80 |
| avazu-ctr · | 0.3263 | 0.3270 | 0.3163 | 0.3507 |
| twitch-views · | 0.7289 | 0.7131 | 0.7320 | 0.7900 |
在 artnet-exp 上,GraphPFN ICL 比 G2T-LimiX 高 3.37 个 AP 百分点;在 tolokers-2 与 avazu-ctr 上则没有占优。微调往往进一步改善结果,例如 twitch-views 的 从 0.7320 提高到 0.7900。
论文报告,GraphPFN ICL 在两个数据集合上相对于 GNN 与 ICL 图基础模型取得最佳平均排名;FT 在 13 个数据集中的 11 个最优,例外为 pubmed 和 questions。这里还有一个重要注脚:pubmed 微调因显存不足未完成,FT 行实际复用了 ICL 成绩。 因此不能把它写成“13 个数据集均成功完成全参数微调”。amazon-ratings 和 questions 还使用主成分分析 PCA,将原始特征投影到 64 个保留较大方差的线性方向,以降低计算和显存需求。对应证据见 Section 5 与 Appendix D。
11.4 消融比总体排名更能解释贡献
G2T-LimiX 与 GraphPFN 的对比同时改变了结构、图特征工程和预训练,不能把差值全部归给一个注意力算子。附录提供了更具体的对照:
| 对照 | 结果及其含义 |
|---|---|
| 相同架构,图适配器随机初始化后再微调 | 性能明显下降,支持合成图预训练具有额外价值 |
| 将注意力适配器换成 GCN / Mean | 注意力总体更好,但 GCN 在 twitch-views 略高 |
| 去掉 MGM | 多数任务下降或相近;city-reviews 略有提高 |
| 更换图结构先验 | ER 通常较弱,简单度修正 SBM 已有很强表现 |
例如 Table 5 的无集成 ICL 结果中,artnet-exp 的 AP 从 ER 的 48.70% 提升到度修正 SBM 的 51.14%、作者先验的 51.46%。但 tolokers-2 上,度修正 SBM 为 61.71%,作者先验为 60.97%;avazu-ctr 的 分别为 0.3298 与 0.3143。
这些结果说明先验选择确实影响迁移,尚不足以证明“生成器越复杂,预测越好”。视觉上更接近真实网络、统计量覆盖更广和下游预测更强,是需要分别检验的目标。
Table 6 的 MGM 消融同样需要克制解读:artnet-exp 的 AP 为 51.46% 对 50.41%,city-reviews 则为 80.01% 对 80.08%。它支持辅助目标有一定价值,而不是每个任务必然改善。这些表采用无集成 ICL,不能把其中的 GraphPFN 数值与主表混用。详见 Appendix B.3 与 Appendix C。
将最关键的预训练对照展开。论文 Table 7 在同样的目标任务 FT 协议下,对比预训练适配器与随机适配器;后者保留 LimiX 骨干,适配器末层零初始化以减小初始破坏:
| 数据集 | GraphPFN FT | LimiX+随机适配器 FT | 指标 |
|---|---|---|---|
| artnet-exp | 53.49 ± 0.81 | 48.06 ± 0.87 | AP(%) |
| tolokers-2 | 62.80 ± 0.39 | 51.64 ± 3.31 | AP(%) |
| twitch-views | 0.7900 ± 0.0014 | 0.7543 ± 0.0082 | R²,已从原表百分数尺度换算 |
架构和下游 FT 流程相同,主要对照是适配器是否有合成图预训练;它比同时改变很多因素的跨模型比较更直接。它支持这套预训练的价值,仍不能单独确定先验中的每个生成机制贡献。去 MGM 时保持其他预训练设置,换 GCN/Mean 时改变适配器结构,换图先验时改变结构生成器;这些对照各自回答不同问题,不能混成同一个因果结论。
11.5 当前结论的适用边界
GraphPFN 展示了表格 PFN 能力与可训练图传播结合的价值,但仍需要整份数据联合计算,大图显存成本明显。骨干原生支持至多 10 类,更多类别依赖 ECOC(纠错输出码)等扩展,即把多类别编码成多个可支持的子任务,再合并预测;先验主要面向社交和信息网络,对几何约束强的图覆盖有限。论文还报告了不同预训练种子的波动。
这些限制也有不同来源。ECOC 将每类对应到一行编码,例如三类可编码为 [1,0,0]、[0,1,0]、[0,0,1],每列构成一个可支持的二分类子问题;预测后合并各列证据寻找匹配的类别编码。这只是最小接口示例,具体纠错能力依赖编码设计与解码,不能将它当作任意类别数的免费扩展。
PCA 作用在输入特征轴:找训练数据中方差较大的正交方向,将每个节点投影为较少的坐标;节点数量不变,保留方差也不保证保留全部预测信号。显存则还包含 [N,F,d_h] 隐藏状态,以及全局样本注意力需要的计算。高效注意力不必显式存下完整 分数矩阵,但全局交互的计算与内存压力仍不同于只有稀疏边的传播。预训练种子波动涉及重新训练出的不同模型,不应与同一个固定模型的推理集成混为一谈。
当前验证范围是节点预测。MGM 是辅助边重建任务,不能据此声称模型已经统一解决链接预测、图分类或图生成。也不能仅凭免梯度 ICL 就推断推理一定便宜:附录计时中,其 ICL 与从零训练 GCN 处于同一数量级,全参数微调则明显更昂贵。
12. 沿着同一份任务,再走一次完整过程
本文用两份明确区分的数据:最初论文相关度表解释图输入与邻居传播;第 9 章确定性生成表解释合成任务。它们共享五个节点和同一边集,但特征含义不同。硬币与六节点 SBM 分别解释概率推断和结构采样,不能把不同例子里的数字当成同一次模型运行。
12.1 四条路径各自怎样闭合
标签到预测。 重排节点使 Context 在前,将已知类编码为目标 Token,Query 使用未知目标嵌入;节点内特征交互和跨样本读取让目标状态依赖当前标签,图适配器进一步更新;取 Query 最后一个目标 Token,经分类头得到 logits 与概率。第 7 章的低维读出演示 [0.8,0.2]→[0.6457,0.3543] 是教学计算,源码路径与实际权重输出分开。
生成器到任务。 固定结构和输入 ,生成 、邻域目标 ,选观测列 ,按教学阈值生成 ,仅向模型提供 A、B、D 的标签。特征、目标和潜在计算列现在都有可见位置。
单样本到总体目标。 真类概率先变成单 Query 负对数损失,再对当前 Query 平均、对划分取期望、对任务取期望;实际批次用有限采样近似这个目标。网络权重共享,任务机制参数重新采样。
一个批次到更新。 已生成数据固定后遮住 Query 真值、删除边监督正样本;一次缺边前向提供节点与边预测,教学损失分别为约 0.2899 与 0.4558,合计约 0.3355。两分支梯度传回适配器,累积与多卡聚合后由优化器更新可训练参数,骨干权重按配置保持固定。
12.2 自测与答案定位
| 问题 | 应能说清楚的答案与回看位置 |
|---|---|
| 为什么只改边,逐节点 MLP 不变而 GCN 可能改变? | MLP 输入没有 A,GCN 的 S 由 A 决定;第 2 章 |
| 后验密度高于 1,为什么仍是合法分布? | 概率由密度乘区间宽度积分,总面积为 1;5.2 节 |
| 为什么同一固定 PFN 可以对不同任务输出不同预测? | Context 及标签属于输入,中间激活随输入改变;4.2、6.2、7.3 节 |
| 同块度有随机差异,为什么还需要度修正? | 波动不等于每个节点拥有不同的长期连接倾向;8.4—8.5 节 |
| 数据图有环为什么不自动使前馈 SCM 循环? | 不同层的变量不同,路径 A⁰→B¹→A² 不回到旧时刻;9.5 节 |
| 样本注意力不读取 Query,为什么 Query 仍可间接通信? | 图适配器先更新 Context,后续全局通路再读取更新状态;7.4 节 |
| 缺边后为什么不重新生成标签? | MGM 在固定生成任务上遮蔽观测,重新生成会改预测目标;10.2 节 |
| 冻结层为什么仍可以传梯度? | 冻结权重更新不等于切断对输入的导数;10.3 节 |
12.3 理解与复现之间还隔着什么
本篇已经核对固定版本源码的数据路径、掩码粒度、分类后处理和目标读取,也复算教学数值;没有加载官方模型权重、没有执行其完整前向或训练。默认代码分支与最终检查点配置未混为一谈。后续最小复现仍应在固定划分上加载权重,核验真实 shape、输出、集成设置和指标。
结构扰动实验可以固定 X 与 Context 标签,只删边或重连;预测变化说明拓扑敏感,结合指标才有助于判断是否利用了有益结构。上述事实边界既适用于正文,也适用于配图中的每个数值。
原文与延伸入口
- GraphPFN v4 全文与固定版本 PDF:架构、预训练、图先验、主实验和附录;官方代码用于后续代码级核对。
- Transformers Can Do Bayesian Inference:PFN 的任务采样、后验预测与期望训练目标。
- GCN、GAT与 Transformer:传播归一化、加性注意力及缩放点积注意力。
- Karrer 与 Newman:Stochastic blockmodels and community structure in networks:普通块模型与度修正的经典定义。
- Barabási 与 Albert:Emergence of scaling in random networks:增长与优先连接机制。