如果一段对话持续几个月,模型应该怎样记住用户曾经说过的话?如果一批文档比模型的 context window 还长,模型又怎样在不把全文一次塞进去的情况下完成分析?
2024 年的论文 MemGPT: Towards LLMs as Operating Systems 给出的回答是:把上下文当成一种需要调度的内存资源。当前能直接送入模型的内容像 RAM,暂时不在上下文里的历史和资料像磁盘;LLM 通过函数调用,把信息在这些存储层之间换入、换出和检索。[1]
这篇论文读起来有一种很鲜明的时代感。今天我们很容易把它理解成“给 Agent 接一个记忆库”,但作者当时试图解决的是更底层的问题:当 LLM 的上下文窗口固定而任务持续变长时,谁来管理模型当前应该看到什么?
本文沿着论文的论证顺序展开。先建立机制,再看长期对话和长文档实验,最后把论文的主张、实验真正支持的范围,以及我们在阅读中发现的边界放在一起。
材料与范围
本文依据 Zotero 文献库中的 MemGPT: Towards LLMs as Operating Systems,记录为 2024 年 preprint,正文版本为 arXiv:2310.08560v2(2024 年 2 月 12 日)。本文复述论文的架构和实验;文中的“我们看到的后续方向”是基于阅读的分析,不是论文已经完成的结果。本文没有复现实验,也没有把这套设计当作当前 Agent 系统的通用最佳实践。
先从一个有限的窗口开始
LLM 每次推理都只能接收有限数量的 prompt tokens。对短问题来说,这个限制不明显;对长对话和长文档来说,问题会逐渐变成:早先的信息已经不在当前输入里,模型也就不能直接使用它。
扩大 context window 是一个自然方向,但论文提出了两个阻力。第一,Transformer 的 self-attention 会让计算和内存成本随输入长度快速增加。第二,能够把更多文字放进去,并不等于模型能均匀、有效地使用这些文字。上下文变长后,信息选择本身仍然是问题。
于是论文把问题换了一个问法:能不能继续使用一个固定长度的模型,却让它像拥有更大上下文一样工作?
这里的“更大上下文”不是说模型参数里多出了一个无限记忆模块。模型在某一轮推理时仍然只能看到有限的内容。变化发生在系统层:当模型需要过去的信息时,它可以把那部分信息重新取进当前窗口。
先把记忆分层,再谈“记住”
MemGPT 把可供模型使用的内容分成两大类:main context 和 external context。
main context 是当前会被拼进 prompt、直接参与推理的内容。它又分成三个连续区域:
| 区域 | 论文中的职责 | 阅读时可以怎样理解 |
|---|---|---|
| System instructions | 说明 MemGPT 的规则、记忆层用途和函数用法 | 操作手册与接口说明 |
| Working context | 可读写的固定大小文本区域,放重要事实、偏好和当前状态 | 小而稳定的工作区 |
| FIFO queue | 保存近期用户消息、模型输出、函数结果和系统消息 | 最近活动的消息队列 |
external context 不会自动参与当前推理。它包含两种外部存储:Recall storage 保存对话和操作记录,Archival storage 保存更大、更长期的资料。只有当模型调用函数搜索外部存储、搜索结果被重新放入当前上下文后,模型才能在这一轮使用它们。
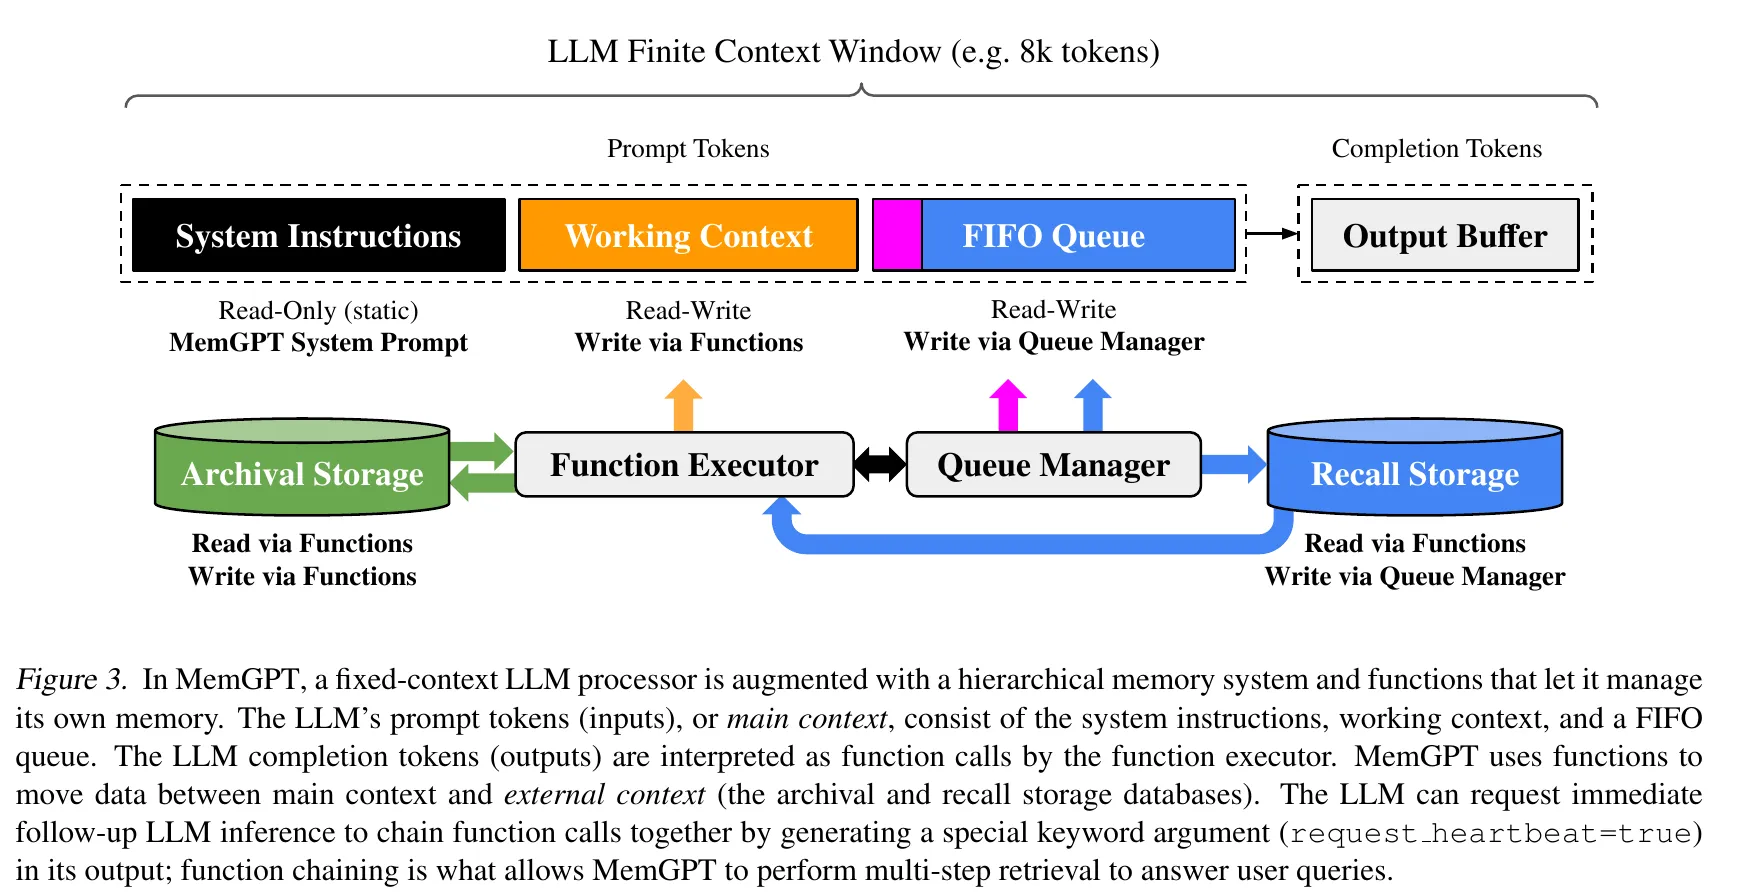
论文的原始架构图把读写责任画得更细:System Instructions 只读,Working Context 由函数写入,FIFO Queue 由 Queue Manager 写入;模型生成的内容先进入 Output Buffer,再被解释为回答或函数调用。我们的自绘图强调“可见与不可见”,下面的原图则适合核对这些组件之间的接口。
这几个区域承担的任务并不相同。一个稳定的用户偏好适合留在 working context;一段很长的历史对话可以留在 recall storage;一批文档则更适合放进 archival storage。
论文前两张示意图用一段持续变化的对话说明这种分工。用户提到生日和男友 James 时,模型可以把简短的个人事实写进 working context;多年对话中关于游乐园的原始消息不必一直放在当前窗口。当用户后来又说与 James 分手,working context 中的关系状态需要更新,而不是继续沿用旧事实。模型若想回忆两人第一次在哪里见面,则可以搜索 recall storage 中较早的原话。这个例子同时包含了更新当前事实与找回历史事件两种操作,它们不应被混成一次普通检索。
上下文压力:系统什么时候提醒模型?
FIFO queue 会不断接收新消息和函数结果。论文设置了两个容量阈值:当 prompt tokens 超过 warning token count 时,Queue Manager 插入 memory pressure 警告;当超过 flush token count 时,Queue Manager 执行队列清退。
警告给模型一个提前处理的机会。模型可以在真正清退发生前,把重要事实写进 working context,或者把资料保存进 archival storage。
如果队列最终需要 flush,系统会移出一部分消息,使用已有的递归摘要和被移出的消息生成新的摘要。被移出的原始消息不再直接出现在当前上下文中,但仍然会被写入 recall storage,之后可以通过函数检索。
这里要区分两件事:队列清退是 Queue Manager 执行的容量控制动作;哪些信息值得提前保存,则依赖模型在警告阶段的判断。
模型不只回答问题,也可以操作自己的上下文
MemGPT 的函数执行器把 LLM 的输出分成普通文本和函数调用。如果模型输出函数调用,系统会解析参数;参数通过校验后,函数才会被执行。执行结果,包括运行时错误,会重新反馈给模型。
当前 main context
        ↓
LLM 判断信息是否足够
        ├─ 直接生成回答
        └─ 生成函数调用
               ↓
         Function Executor
               ↓
      函数结果或运行时错误
               ↓
        回到当前上下文
               ↓
          LLM 继续推理
函数主要做三类事情:修改 working context,搜索 recall 或 archival storage,以及请求系统在函数完成后立即继续下一轮推理。
最后一种能力构成了 function chaining。模型可以先搜索一页结果,发现还需要更多信息,再继续翻页;也可以先从一个键查到下一个键,再用新键发起下一次查询。
论文把用户消息、系统警告、用户操作和定时触发都称为 event。一个 event 到达后,MemGPT 将其转成消息并触发推理。模型可以直接回答,也可以调用函数;如果请求立即继续,函数结果会进入上下文并触发下一轮,否则系统等待下一个 event。
实验一:长期对话中的深层记忆
论文首先用 Multi-Session Chat 数据集测试长期对话。每组数据有五个历史 session,作者再增加第六个 session,并在其中提出必须依靠早期对话才能回答的问题。
第一个任务叫 Deep Memory Retrieval,测试模型能否找回用户过去说过的具体事实。固定上下文基线只能看到历史摘要;MemGPT 可以访问完整历史,但必须通过分页搜索把相关内容取回 main context。
| 底层模型 | 固定上下文基线 | MemGPT |
|---|---|---|
| GPT-3.5 Turbo | 38.7% | 66.9% |
| GPT-4 | 32.1% | 92.5% |
| GPT-4 Turbo | 35.3% | 93.4% |
这个结果支持一个具体判断:对于“过去某次对话中到底说过什么”这类问题,按需检索完整历史,可以明显好于只依赖压缩摘要。
但它不能单独证明所有提升都来自 MemGPT 的控制流。基线和 MemGPT 能看到的信息不同:前者看摘要,后者能访问完整历史。因此,这个实验同时比较了两种记忆内容和两种使用方式。
第二个任务是 Conversation Opener。模型在新的 session 开始时生成开场内容,作者观察它是否使用了过去累积的 persona 信息。这个任务测试的不是用户明确要求回忆时能否检索,而是模型能否主动把长期信息用于后续互动。
论文用生成开场白与 persona 标签、人工开场白的相似度来评估这一任务,并报告 MemGPT 有时可超过人工开场白。这个指标的含义需要收紧:覆盖更多 persona 信息,可能说明模型使用了更多历史资料;它并不直接等于对话一定更自然、更贴合用户当时的心情。作者也观察到模型生成的内容往往比人工版本更长,较高的相似度可能与这种信息覆盖方式有关。
实验二:长文档与多跳检索
第二个场景是文档分析。作者把 Wikipedia 文档和预计算的 embedding 放进 archival storage,用 PostgreSQL、pgvector 和 HNSW 索引支持向量搜索。固定上下文基线和 MemGPT 使用同一个检索器,差别在于检索结果怎样进入 LLM。
固定上下文:检索 top-K 文档 → 直接拼进 prompt

MemGPT:文档集合留在 archival storage
       → LLM 调用搜索函数
       → 结果分页进入 main context
       → 必要时继续搜索
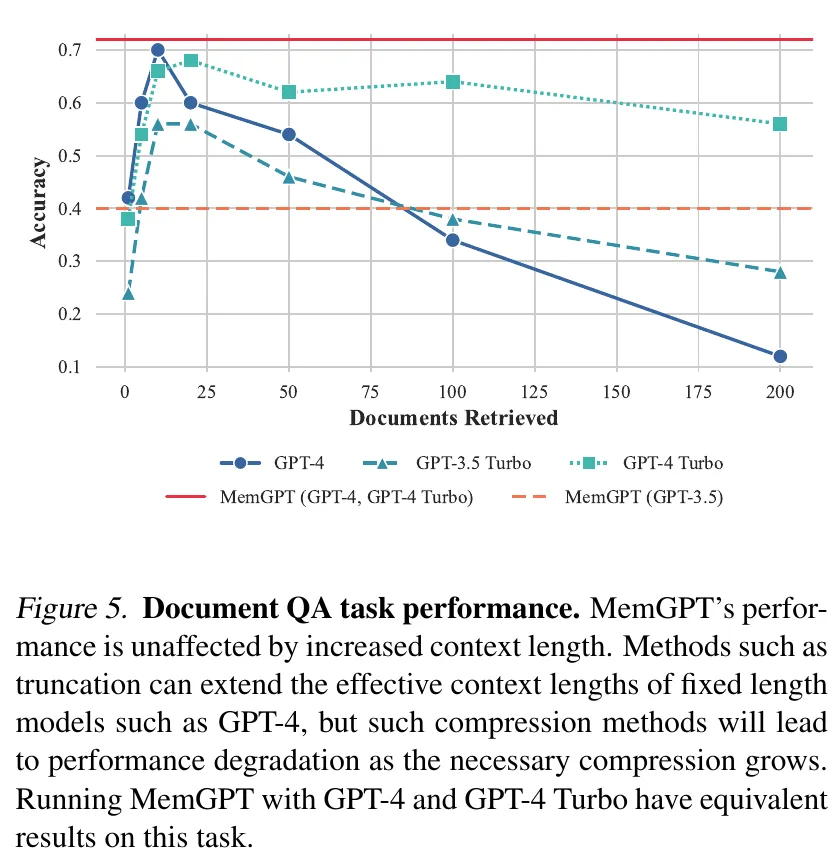
论文 Figure 5 展示了候选文档数增加时的准确率曲线。横轴是检索文档数,纵轴是回答准确率;带 MemGPT 的 GPT-4 曲线基本保持水平,而直接把更多文档送进固定上下文的 GPT-4 曲线随后下降。图中比较的是论文选取的 50 道 NaturalQuestions-Open 问题,答案由 LLM judge 评估。它说明这种上下文组织方式在该设置下有效,不等于所有文档检索任务都能保持同样的准确率。
作者还设计了 Nested Key-Value Retrieval。一个 key 的 value 可能本身又是下一个 key,模型必须连续查找:key A → key B → key C → 最终答案。普通模型随着嵌套层数增加很快失效;论文报告 MemGPT 的 GPT-4 版本可以通过重复查询完成多跳查找。这个实验的键值对总量约为 8k tokens,作者改变的是嵌套层数和键的位置。GPT-3.5 在一层嵌套时已降至 0%,GPT-4 到三层嵌套时降至 0%;带 MemGPT 的 GPT-4 曲线则保持稳定。较弱底层模型即使接入 MemGPT,也可能因为调用次数不足而失效。这个结果提醒我们:函数接口提供了多步路径,模型还必须实际走完它。
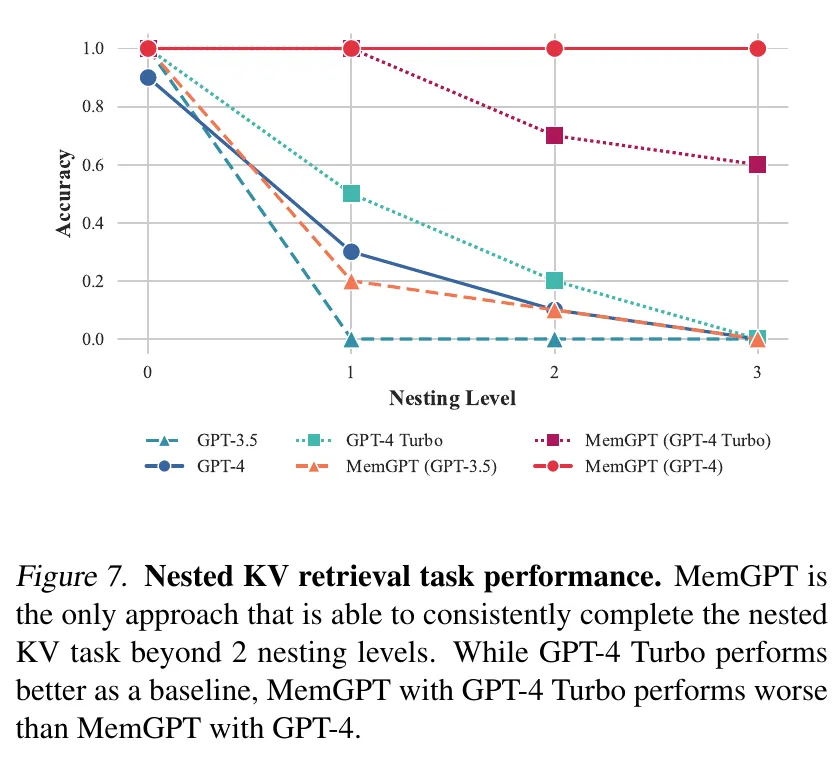
这张图还提醒我们,MemGPT 的收益并不对所有底层模型一样。MemGPT 加 GPT-4 保持高准确率,MemGPT 加 GPT-4 Turbo 到较深层数仍然下降;前面说的“函数接口存在”与“模型稳定完成多次调用”,正是两件事。
这里还要避免把两种文档实验混为一谈。多文档问答主要观察候选文档越来越多时的回答准确率;嵌套键值任务则把语义难度压低,突出“上一轮结果能否驱动下一轮查询”。前者更接近真实资料检索,后者更适合单独检查函数链是否真的运行。
这个合成任务很适合说明 function chaining 的作用:模型需要保存中间结果,并把它用于下一次调用。它能证明多跳函数查询可行,但不能直接代表真实文档中的开放推理任务。
论文的贡献边界
论文确实展示了一个早期的系统级方案:固定 context window 的 LLM 可以通过分层存储、函数调用、分页检索和事件驱动控制流,处理超出单次上下文容量的对话与资料。
实验支持几个较窄的判断:完整历史的按需召回有助于深层事实问答;working context 可以帮助长期个性化;函数链可以支撑受控的多跳查询;外部存储可以减少一次性塞入 prompt 的压力。
但“无限上下文”更准确地说是一种系统层效果。每轮 LLM 推理仍然只看有限内容,系统依赖检索把正确内容找回来,也依赖模型判断什么时候应该查、保存和继续。检索失败、保存错误或函数链过早停止时,这种效果就会消失。
我们一路读到的几个问题
首先,模型同时承担了太多控制职责:它既要回答问题,也要判断什么值得保存、保存到哪一层、什么时候检索、是否继续翻页和何时结束。这正是它在当时有创造力、今天看又有些别扭的地方。
其次,记忆质量依赖模型主动调用函数。如果模型没有保存某个事实,之后就无法可靠找回;如果它保存了错误信息,错误内容可能持续影响后续对话。论文提出了记忆机制,但没有充分解决冲突检测、纠错和过期处理。
再次,实验基线需要谨慎解释。对话实验让基线看历史摘要,让 MemGPT 访问完整历史;文档实验沿用了已有的向量检索器;Nested KV 是结构高度规则的合成任务。因此,结果说明这套系统组合有用,不能直接推出它已经解决了通用长期记忆。
最后,多轮函数调用有成本和停止问题。它可能带来更高延迟和 token 消耗,也可能过早停止或反复检索。论文展示了函数链能够运行,但没有充分解决稳定的预算控制与终止策略。
为什么今天回看,它会显得有些别扭?
作者把长上下文、RAG 和 Agent 控制流放进了同一个“LLM 操作系统”框架。模型既像推理器,也像工具使用者和内存管理器;Queue Manager 又同时处理队列清退、摘要和事件调度。
从今天的系统设计角度看,容量计数、分页、权限、调用次数、循环上限和状态持久化,更适合由确定性的 runtime 控制;模型更适合提出语义上的意图:
LLM:我需要找回用户过去关于项目 X 的信息
Runtime:检查权限、选择存储层、分页、限流、记录状态
Tool:执行搜索并返回结果
LLM:阅读结果,决定是否继续或回答
MCP 更偏向工具接入和描述;MemGPT 讨论的是上下文、记忆与控制流怎样协同。它们不是同一个层,但 MemGPT 提前暴露了 Agent runtime 必须面对的问题。
后续可以继续发展的方向
论文提出的方向包括更多大规模上下文任务、不同的数据库和缓存层,以及更好的控制流和记忆管理策略。沿着我们的阅读,还可以继续追问:
- 分开模型判断和运行时约束。 模型可以提出“这条信息可能值得保存”,但是否写入、写入哪一层和是否超过调用预算,应由 runtime 负责。
- 为记忆建立生命周期。 记忆需要创建、更新、合并、冲突处理、过期和删除;每条记忆还应该带来源、时间和置信度。
- 把检索质量和回答质量分开评估。 需要分别测量写入、召回、相关性、上下文装配和最终答案。
- 控制函数链成本和结束条件。 系统需要记录调用预算,设置终止条件,并能诊断模型为何停止或反复搜索。
- 比较不同记忆范式。 MemGPT 关注上下文与外部存储之间的分页;后来的系统还会关注结构化记忆、记忆链接、记忆演化和任务经验。
读完之后留下的主问题
MemGPT 最值得保留的思想,不是“让模型拥有无限记忆”这句表述,而是它提出了一个系统问题:context window 不应只是一个静态长度限制,它也是 Agent 需要管理的运行时资源。
论文证明了分层存储、主动检索和函数链可以让有限上下文支撑更长的任务,同时也暴露了下一步的难题:记忆管理不能长期只依赖模型临场决定。可靠的 Agent 还需要明确的状态、来源、生命周期、权限、成本和评测边界。
从这个角度看,MemGPT 是一个早期但有代表性的 Agent runtime 原型。它把问题完整地摆到了桌面上:模型如何记忆,系统如何调度,外部工具如何参与,以及我们怎样判断一次“记住了”究竟完成了哪一步。
参考文献
[1] Charles Packer, Sarah Wooders, Kevin Lin, Vivian Fang, Shishir G. Patil, Ion Stoica, Joseph E. Gonzalez. MemGPT: Towards LLMs as Operating Systems. arXiv:2310.08560v2, 2024. Zotero item key: XTJH73AV.